封面提示词:ultra high res portrait shot, a figure wearing a large golden spiked crown, the figuredface is entirely wrapped in black cloth, crimson red backdrop, aggressive baroque art style, hyper realistic, professional studio lighting, faint film grain, ethereal glow Centered at very bottom, small barely visible but legible font: "KnightWorld" --chaos 10 --ar 16:9 --exp 5 --raw --profile 1u3p89r --stylize 75 --hd
上周精选✦
Meta Muse 两个模型发布 + Gemini 4 Argon 上线
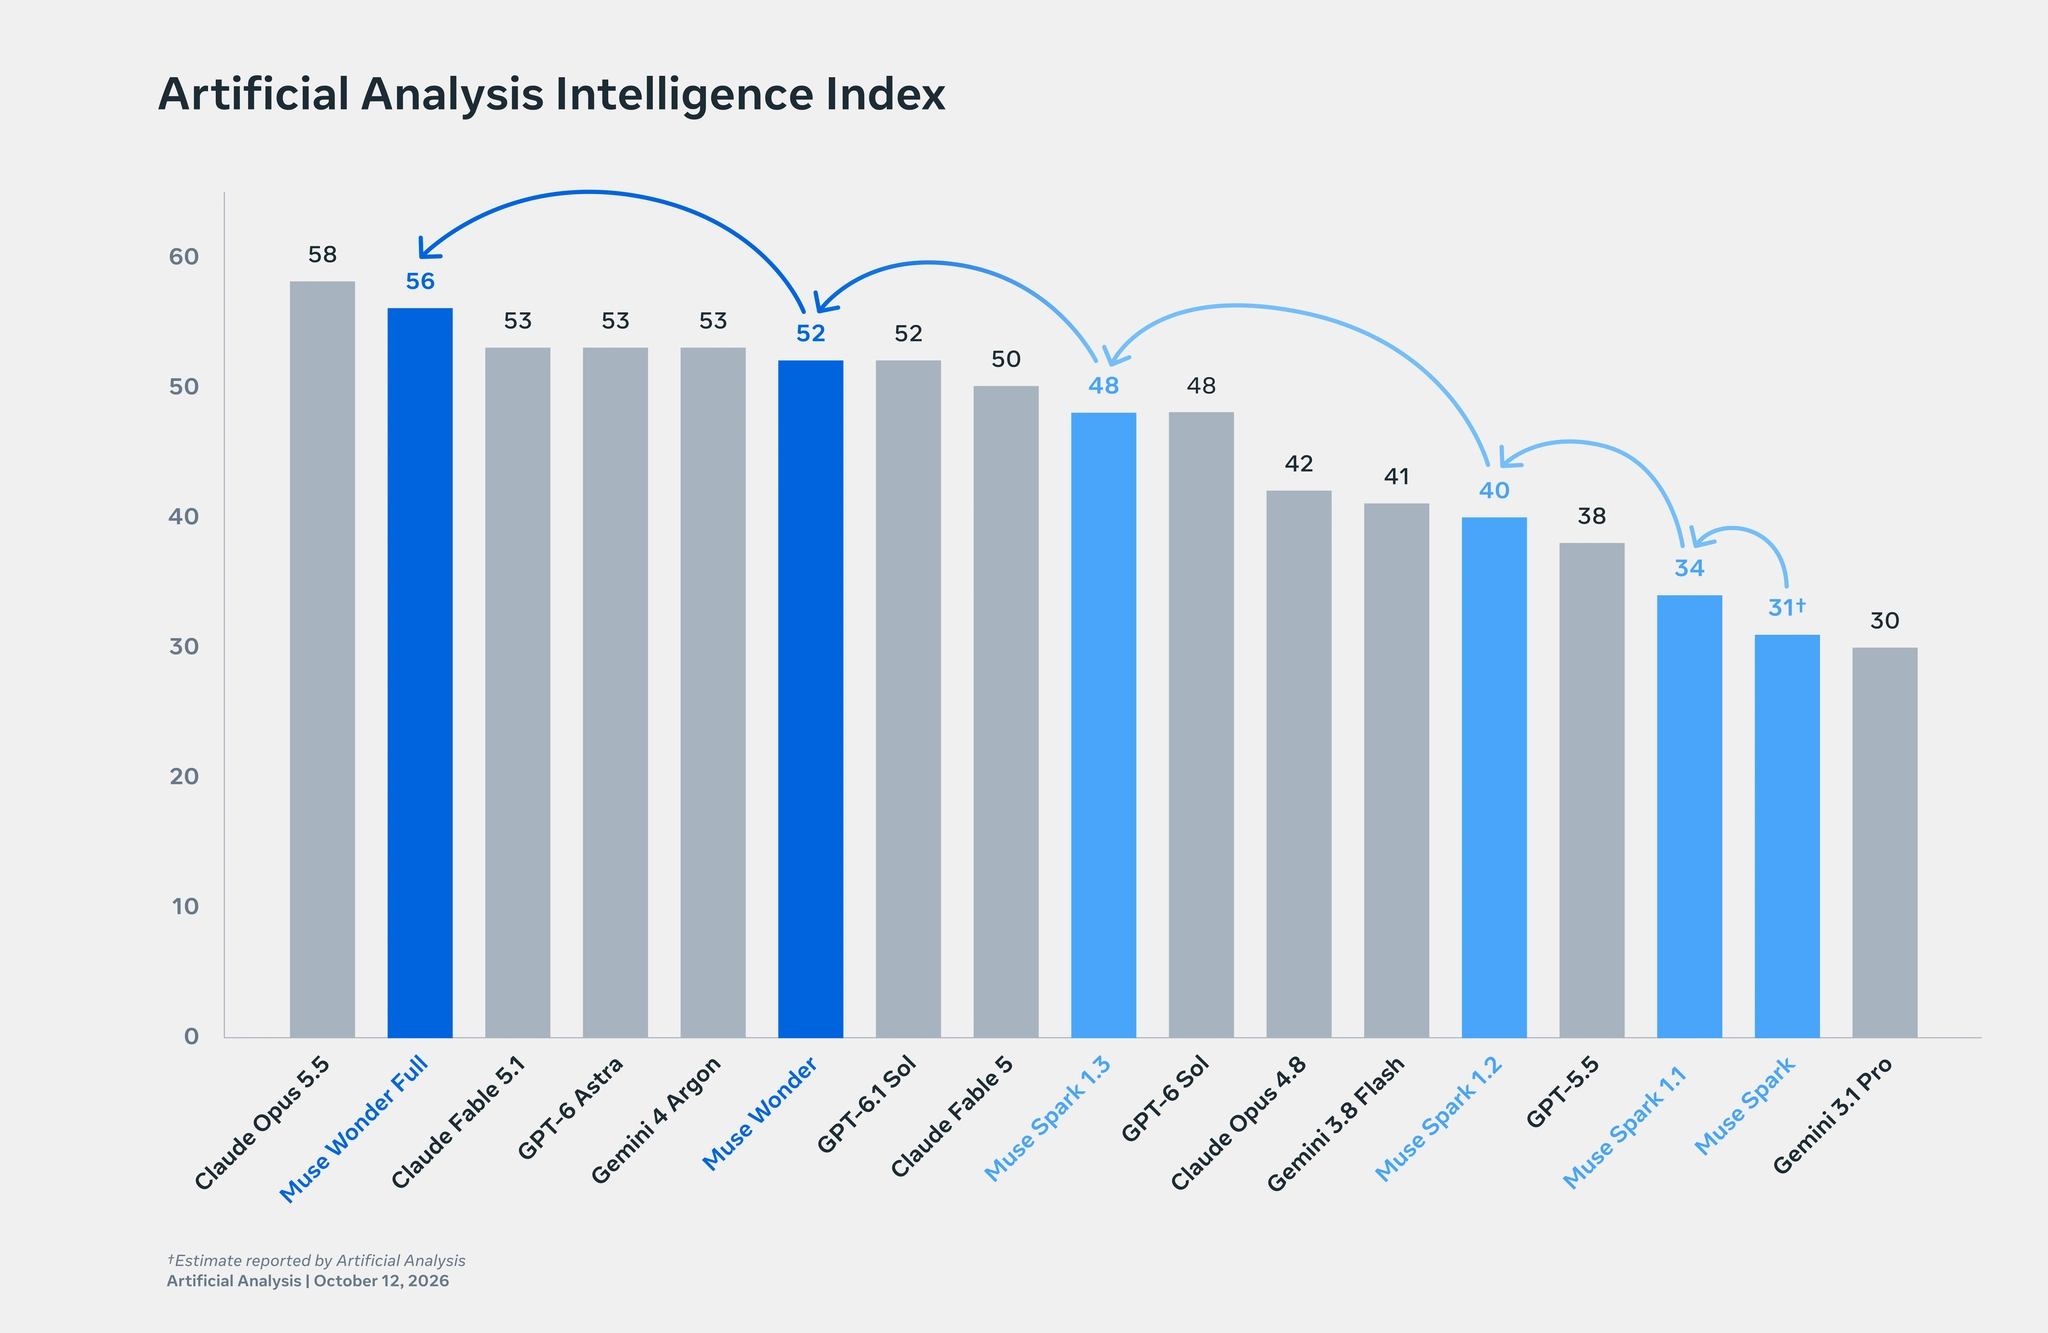
上周模型发布主要看 Meta 和 Gemini,Meta 发布了 Muse Wonder 和更强的 Muse Wonder Full,定位个人和专业 agency 的任务。
Muse Wonder 可以通过 Meta Model API 和 Meta Code 使用,价格是输入 $4/M tokens、缓存 $0.2/M tokens、输出 $20/M tokens,支持 1M 上下文。
Muse Wonder Full 仅能通过 Muse Code 的 Power 和 Max 两个等级订阅使用。虽然基准测评挺高,但很多人觉得这两款实际不太行。
尤其是在容易出效果的 3D 和视觉前端任务上,效果比较差,速度也慢(大家说是 Wonder Full 还可以,但 Wonder 确实不太行)。
Meta 还发布了 Muse Spark Open 开源模型,816B 总参数、42B 激活的 MoE 架构,支持 1M 上下文。Meta 自称是美国迄今为止最强的开源模型。
本地自部署至少需要 700GB 显存。智力指数(AA Index)为 39,比 GL 5.3 的 45 和 Kimi K3 的 44 都要差一些。专门针对 MLX 做了优化,可以在两台 M5 Mac Studio Ultra 上跑。
Google Gemini 4 上周正式发布,但口碑非常拉胯。我自己试了一下,主要是谷歌的模型基建太差,导致甚至不知道能在哪用。在 Antigravit 里面用非常慢,思考过程频繁卡住,到最后我也没跑出一个完整的案例出来。只能说谷歌还是老老实实卖它的算力吧。
AI 时代的财富怎么分配
我觉得比较重要的一个点,就是 Anthropic 为什么执着于在 11 月上市?
他们一定是看到了一些东西。最近很多 Anthropic 的员工也出来说,觉得明年 RSI(自我迭代/递归自我改进)就能彻底解决并完成自动化,也就是 AI 能够自我进化了。
Anthropic 自己的经济模型算出,AI 增长越激进,流向资本的份额就越高,所以他们拿出一部分公司股份在上市前设立了一个公益基金。
看一下具体的方案细节:
- 经股东批准后,公司会先把 5% 的股份投入新设的基金中。
- 在设定的估值基线上,公司估值每增长 50%,董事会就会再追加 2% 的股票投入该基金。
- 该基金是一家全资的 LLC,持有的这部分股权不可用于美国或海外的游说及政治捐款。
- 资金用途:向传统非营利机构大额捐赠,或直接分配给特定人群(重点点名了应对劳动力市场的冲击)。
- 联合创始人承诺捐出 20% 的股权,约一半的员工也愿意参与这项捐赠计划,合计约 20% 的股份将用于公共利益。最核心的其实是直接分配给特定人群,估计会直接向受 AI 冲击较大的人群发放股权。
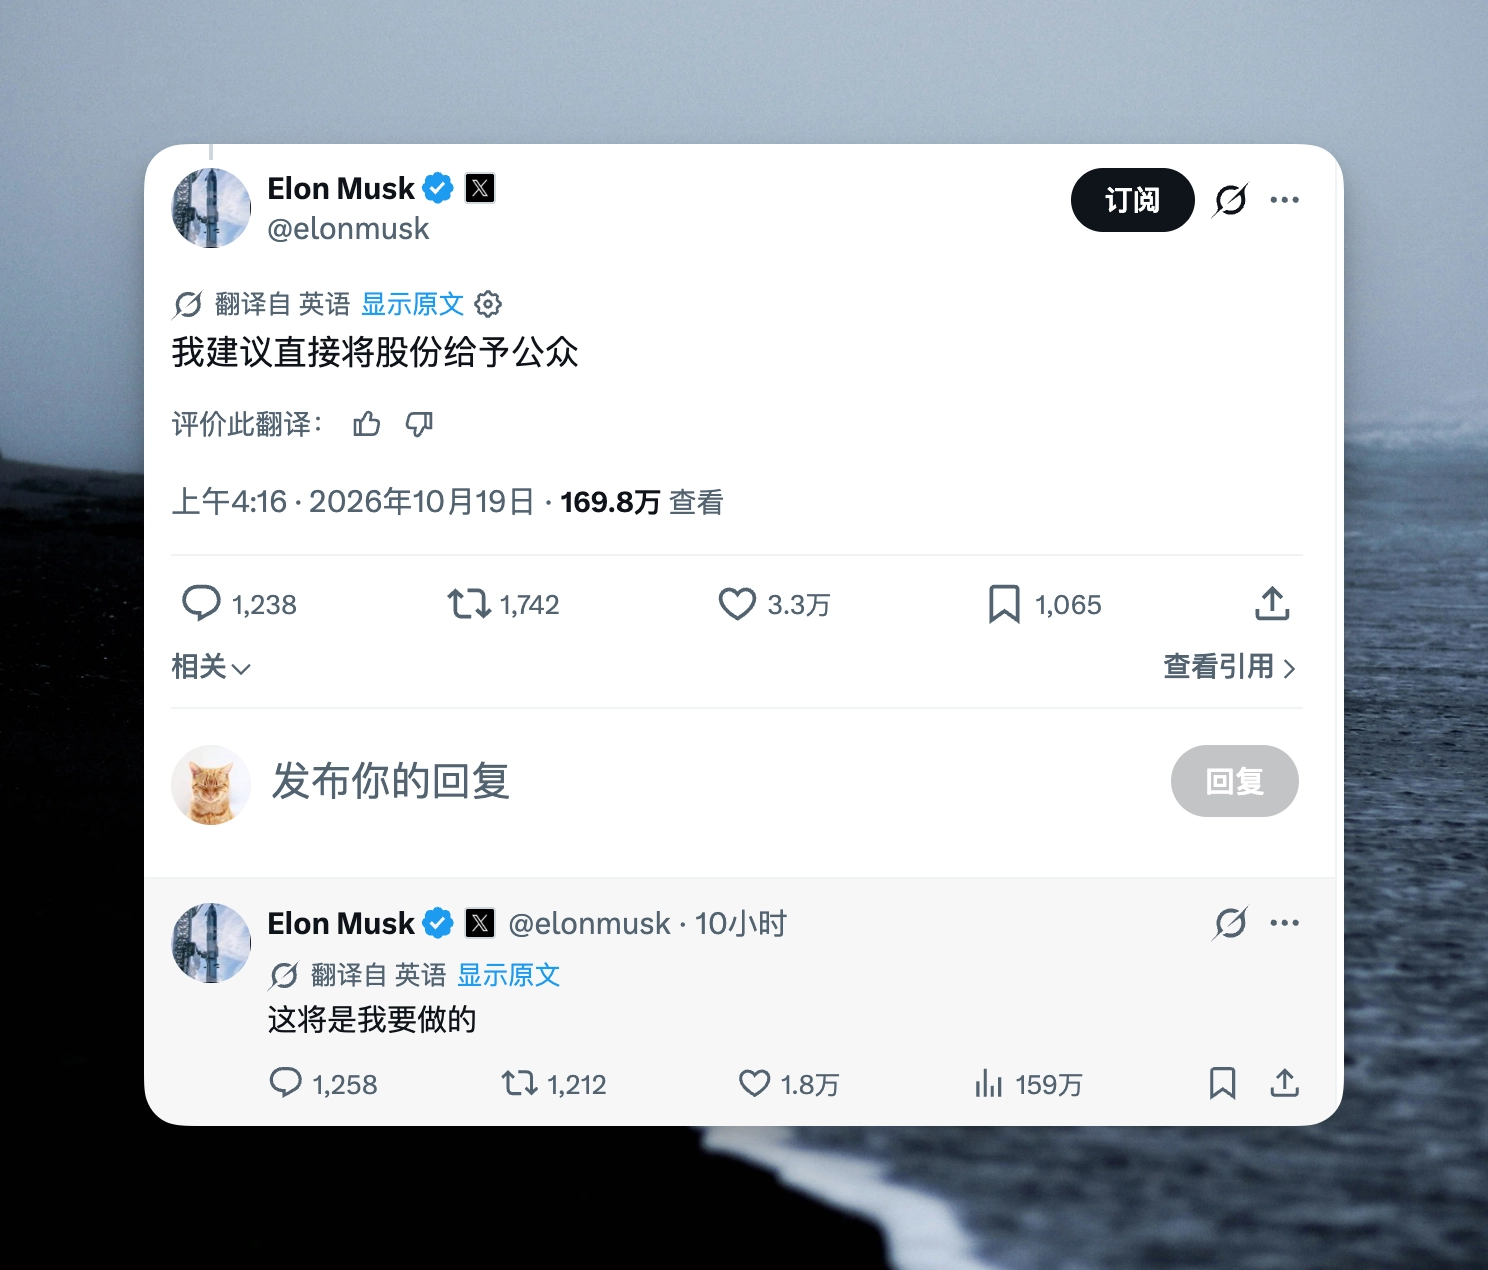
马斯克在 Anthropic 的官方 Twitter 下回复,建议直接把股份发给所有人(即面向公众)。他说自己就打算这么做:
明年首先会给每个美国儿童发放一股 SpaceX 股票;这只是第一次,后续还会多次向美国人(或受影响的人群)发放 SpaceX 股票。
马斯克还在 Twitter 上发出了另一个判断:除非爆发世界大战,否则按美国的有用产出计算,到 2030 年 AI 带来的总增长(GDP 年增)会达到 50% 以上。
此外,OpenAI 今年 4 月也提过一个类似计划,设想通过分红把收益直接分给美国公民。
我觉得他们确实看到了一些趋势,这是非常重要的事情。一旦 RSI 真正实现,对整个社会的冲击将极其巨大。他们对于未来,可能既乐观又不乐观。
DeepSeek 开源 V4.1 Flash 1017 模型
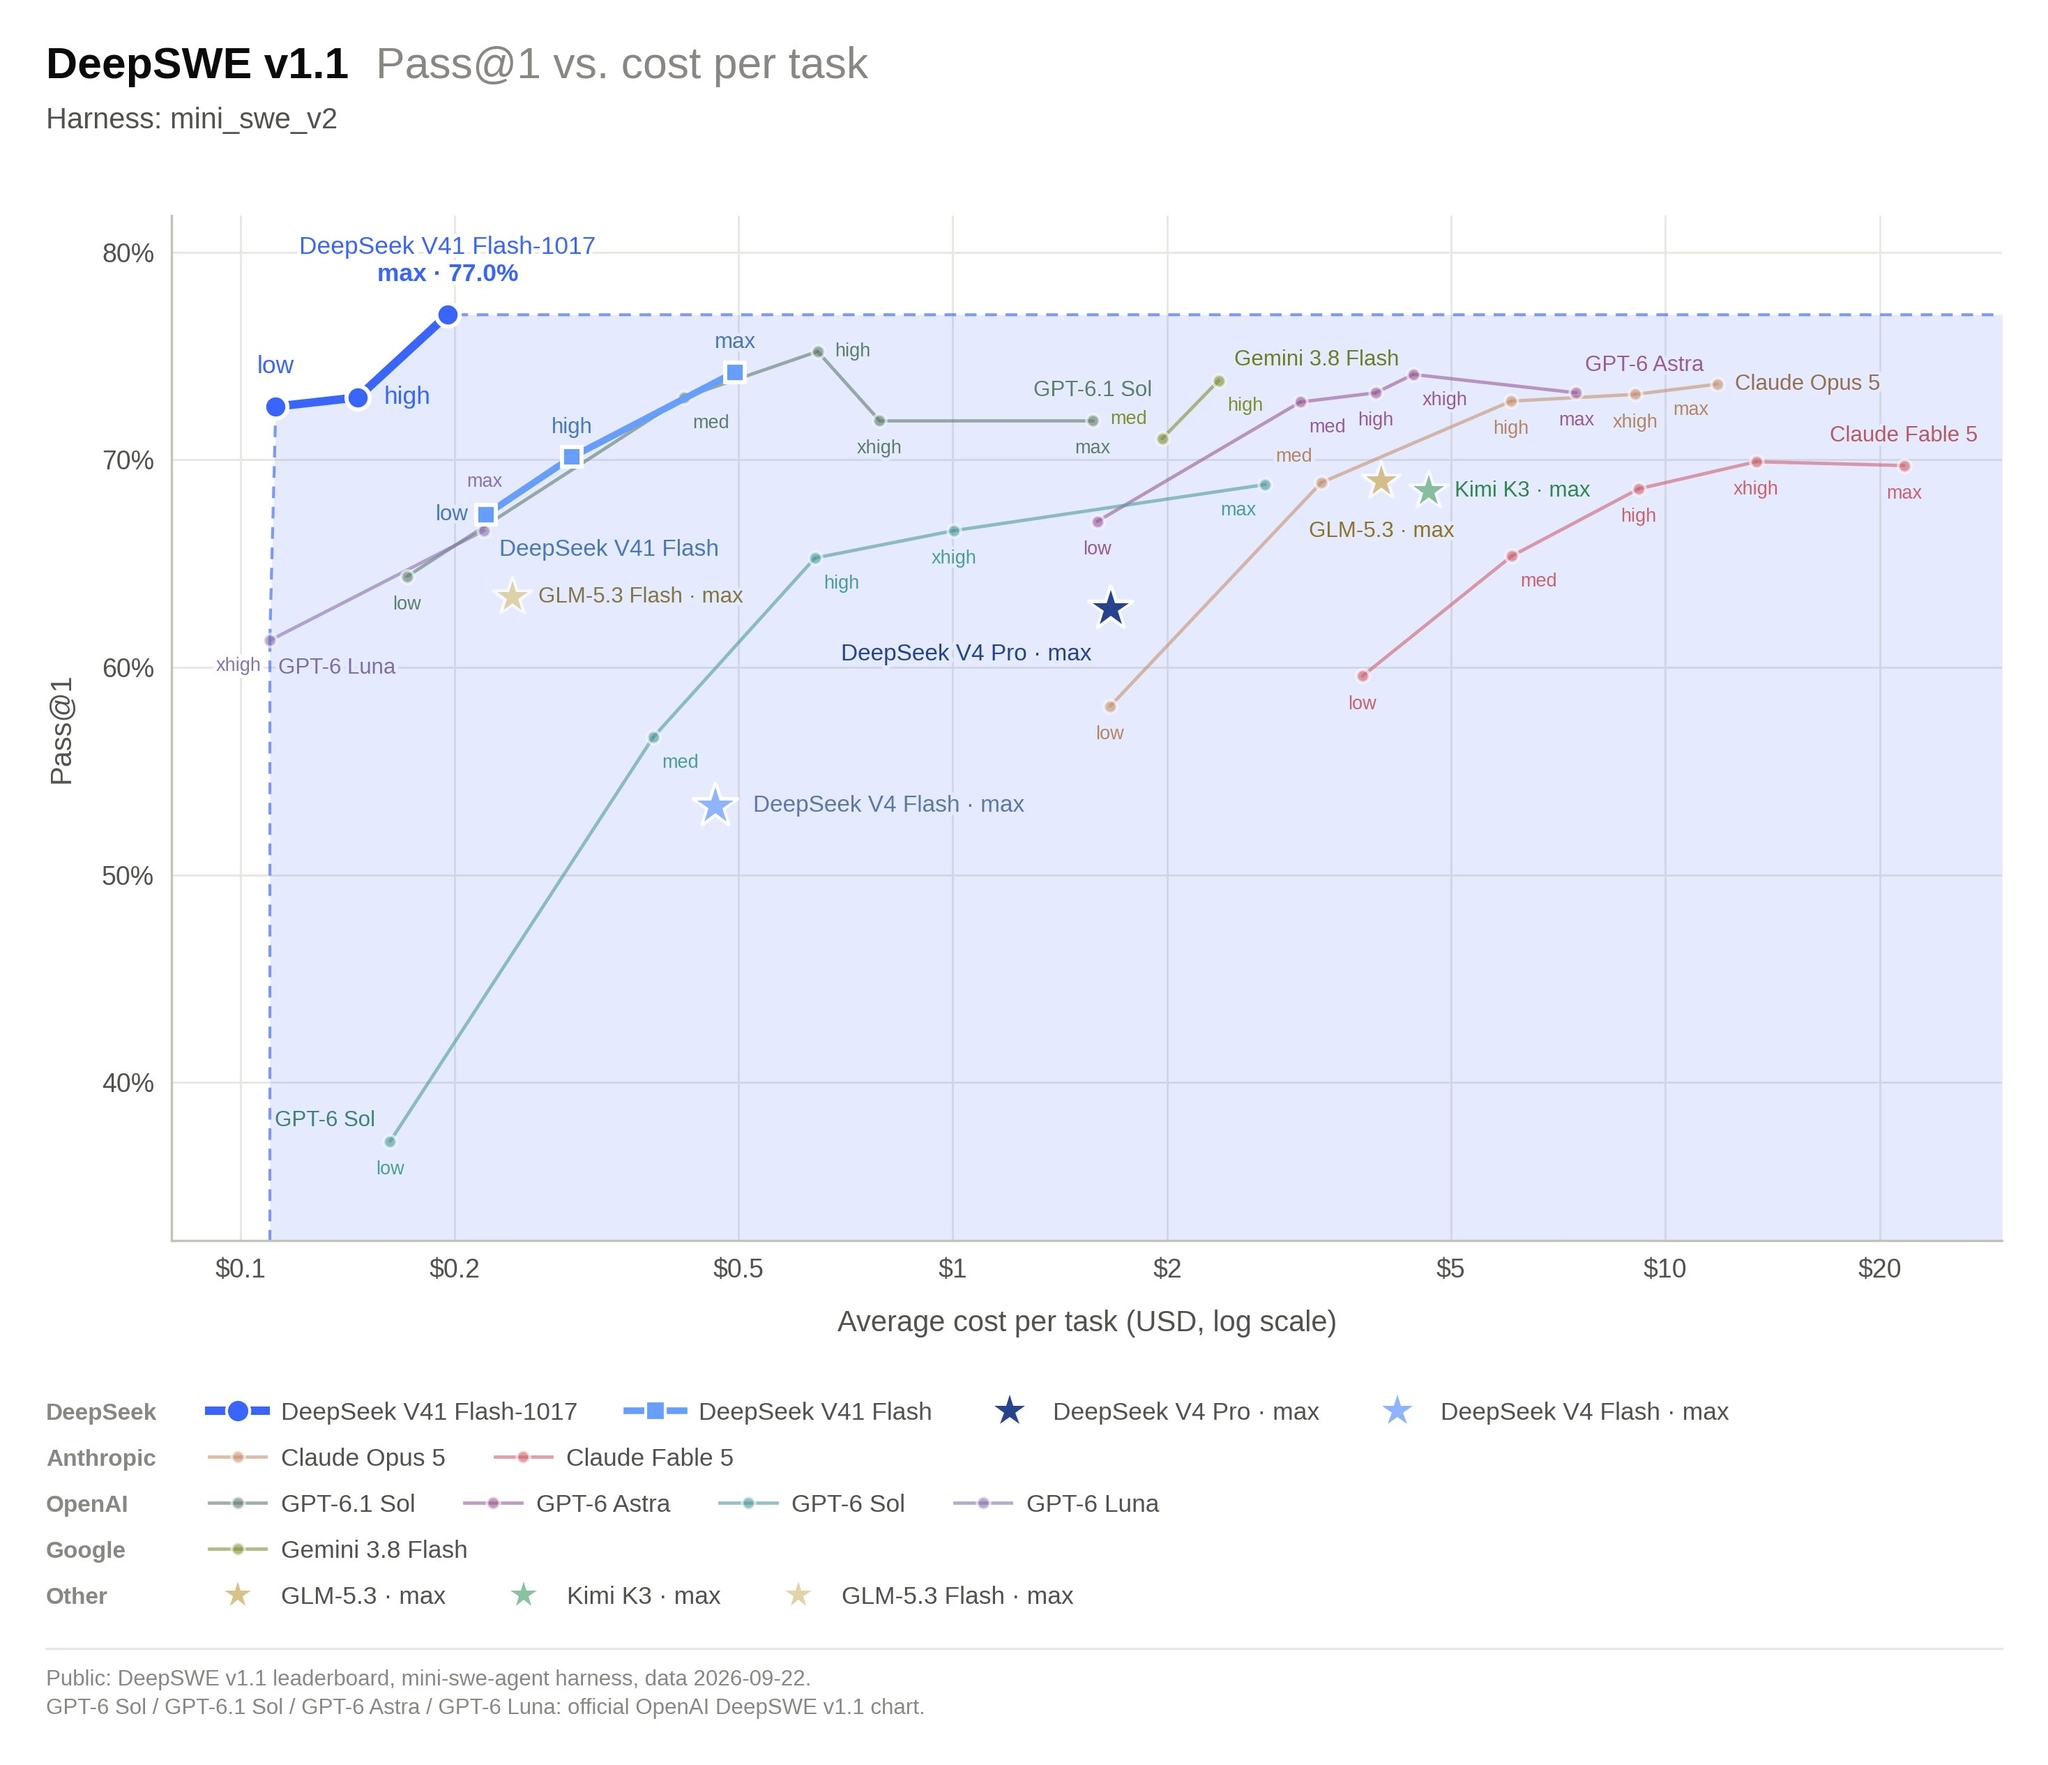
Deepseek 上周事儿比较多,主要是发布了 V4.1 Flash 1017 版本。
但是他们自己这个 Deepseek SWE 1.1 的测试集非常离谱:在这个测试集上,V4.1 Flash 1017 不管是从成绩上还是成本上,都完爆了所有的模型,不知道他们咋测的。
整体能力再次大幅提升,同时缩短了模型的任务运行时间和输出长度,能以更低的成本完成同样的任务。同时大幅改善了他们之前那种“雷霆大思考”一下思考非常长、不输出的毛病。
他们还着重强调了可以从零开始完成整个项目的开发,不用人工干预,只需要非常简单的提示词就行。比如类似 Opus 5.5 这种,一句话做个视频或者一句话做个游戏。
还有一个比较重要的点,就是它开放了自研的搜索 API。Deepseek 在国内信息数据的搜索结果上非常精准,而且非常强,所以这个 API 挺有用的,可以跟你自己的 Harness 配上
还有一个是上周他们宕机了半天,情况比较严重。但结果他们宣布,直接退还从宕机开始往后 7 天所有的 API 消耗。有人消耗了五六十万,都退回到了账户里,这个还是挺猛的。