封面提示词:A giant ancient deer-like mythical beast, far larger than a human, with massive, gnarled, withered wood-like antlers. The deer's head is cold and stern with pale blue glowing eyes, its neck covered in thick grayish-white fur, and its torso clad in coarse blue-gray scales. Its limbs are thick and powerful, with fur fluttering in the wind, exuding an aura of majesty and ancient sorrow. Standing beside the beast is a Taoist priest with an immortal air, his white hair tied in a bun, wearing a grayish-white ancient-style robe with fluttering sleeves and ribbons, cradling an ancient zither in his arms. --ar 16:9 --exp 40 --sref 3818841042 2306239852 1759006419 --profile 1c1f1di --hd --raw
上周精选✦
TypeSafe 的新型模型 JEV
上周最火的模型是由 AI 公司 TypeSafe 开发的 JEV 模型。它和现在的大语言模型(LLM)截然不同,你可以把它当成一个通用的分类器。
它不会像普通大语言模型那样输出长篇文案或进行对话,而只针对输入的问题给出判断。主要支持三种类型的判断:
- 选择题:比如"以下哪个选项更好",直接输出判断后的选项结果
- 内容打分:不局限于纯数字打分,还包括好中差、优质劣质,或者 1-10 分、0-100 分等各种通用评分
- 是非判断:回答诸如"是真的吗"、"能用吗"这类通用问题,输出布尔值(0 和 1)
举个例子:
普通 LLM 的处理方式是看完一段字幕,分析哪里适合剪辑、说明理由并给出剪辑方案;而 JEV 的任务则是对给定的字幕逐句进行独立判断,比如是否包含完整观点、是否有具体建议、是否依赖前文,最终给出每一句对应的"是/否"结果。
官方将它的定位称为 System 1(系统 1),即快思考慢思考中的"快思考":属于不需要复杂推理、下意识得出结果的思考模式。
它最大的亮点在于速度。
在日常使用 LLM 编写程序并进行大批量数据或内容处理时,往往面临速度过慢的问题;而 JEV 的速度极快,成本极低,尤其适合大规模数据处理。
核心机制与训练方式:
- 训练路线称为 RLCD(面向校准决策的强化学习),核心在于优化判断与概率,让概率能够真实反映结果的不确定性。
- 官方批评了当前的 RLHF,认为人们在表达时往往偏好特定说法,却无法提供可信的不确定性。
- 它改变了架构、采样器和训练算法,并非只是给普通模型套上提示词,也没有完全绕开预训练阶段;底座信息、网络结构、奖励公式等细节目前尚未公开,后续会开源 。
- 极速的原因在于:普通自回归模型即便最终只需要 JSON 格式,在思考和输出字段、取值的过程中也需要逐 token 生成;而 JEV 官方表示其会先并行输出判断所需的概率,完全省去生成自由文本和逐 token 吐字的过程,直接返回极简结果 。
- 支持多问题并行评估:可以在一次请求中同时输入多个独立问题,无需让每个问题都走一遍对话流,且增加问题对响应时间的影响很小(例如对同一段字幕检查 10 个维度,它能一次性返回所有独立判断供代码调用;若用普通 LLM,要么开 10 个并发推高成本,要么串流处理极其耗时,且即便是并发往往也不如 JEV 迅速)。
核心优势:低延迟、多问题并行评估、输出种类固定、输出置信度概率、成本极低:输出免费,输入仅需 $0.042 / 百万 token。
当前劣势与局限:
- 多跳推理和复杂指代能力较弱,不适合让它处理需要绕几层关系才能推导出的结论
- 数学计算、计数和日期处理不可靠(这部分建议交由代码完成)
- 倾向于字面理解,无法理解隐喻
- 无关的上下文会降低其准确率,需要前置过滤和清洗检索到的内容
- 容易受到恶意输入影响,提示词注入等风险比前沿大语言模型更为严重
- 各个独立判断之间无法保证逻辑一致性
- 目前仅支持纯文本输入,暂不支持音频与视频
- 中文表现弱于英文(训练阶段未经历足够的多语言数据训练)
- 不会生成文字解释,因此遇到错误时,需要主动检查输入问题、评判标准并定位对照样本
怎么使用
目前他们官方渠道的使用资格需要申请,一般申请后一天多就可以获得资格。
建议在申请的时候,把问题回答一下(申请方式分为“只填邮箱”和“回答问题”两种,建议选择回答问题)。
另外,还有两个渠道可以免费使用这个模型,而且不需要申请:Vercel 的 AI Gateway、OpenRouter。它的官方后台在这里,官方文档在这里。
在适配上,JEV 的适配主要分成两层。接通接口非常简单,但要发挥它的优势,需要把任务改造成明确的小判断和代码组合。对于已经用大语言模型做分类和评分的地方,改动比较小;但对于聊天和自主规划的 Agent,则需要做比较大的改动。
接口层: 它的原生协议和聊天模型不同。通常大语言模型是接收 messages,返回消息或工具调用;而 JEV 的原生接口输入是模型、待评估的材料和问题,输出则是按问题 ID 返回选择、评分或概率。所以这块需要重新进行适配。
POST <https://api.typesafe.ai/v1/systemone>

输入:model + state + questions
输出:answers + usage
提示词方面,建议从"描述任务"转变为"定义判断标准"。这里有两个容易踩的坑:
- 概率部分代表的是命题成立的概率,而不是质量得分
- 评分时必须明确定义等级和含义,不能只要求"给个分数",必须定义每个分数的具体要求
工作流层面: 建议把独立问题合并,这样才能发挥它的速度优势。传统流程可能是依次判断是否值得处理、判断类型、判断质量、判断下一步;而 JEV 可以给出同一份材料,一次性问完所有需要做的判断,让它并发完成,最终返回一个代码组合的结果。
此外,JEV 虽然支持包含聊天历史,但并不要求把全部历史原样塞回去。建议先检索出材料,明确相关字段组织,把比较确定性的规则留在代码里。在工具调用方面,它能够选工具,但不能直接接管整个 Agent,所以很多时候依然需要大语言模型配合
团队背景
查了一下他们的创始团队背景:
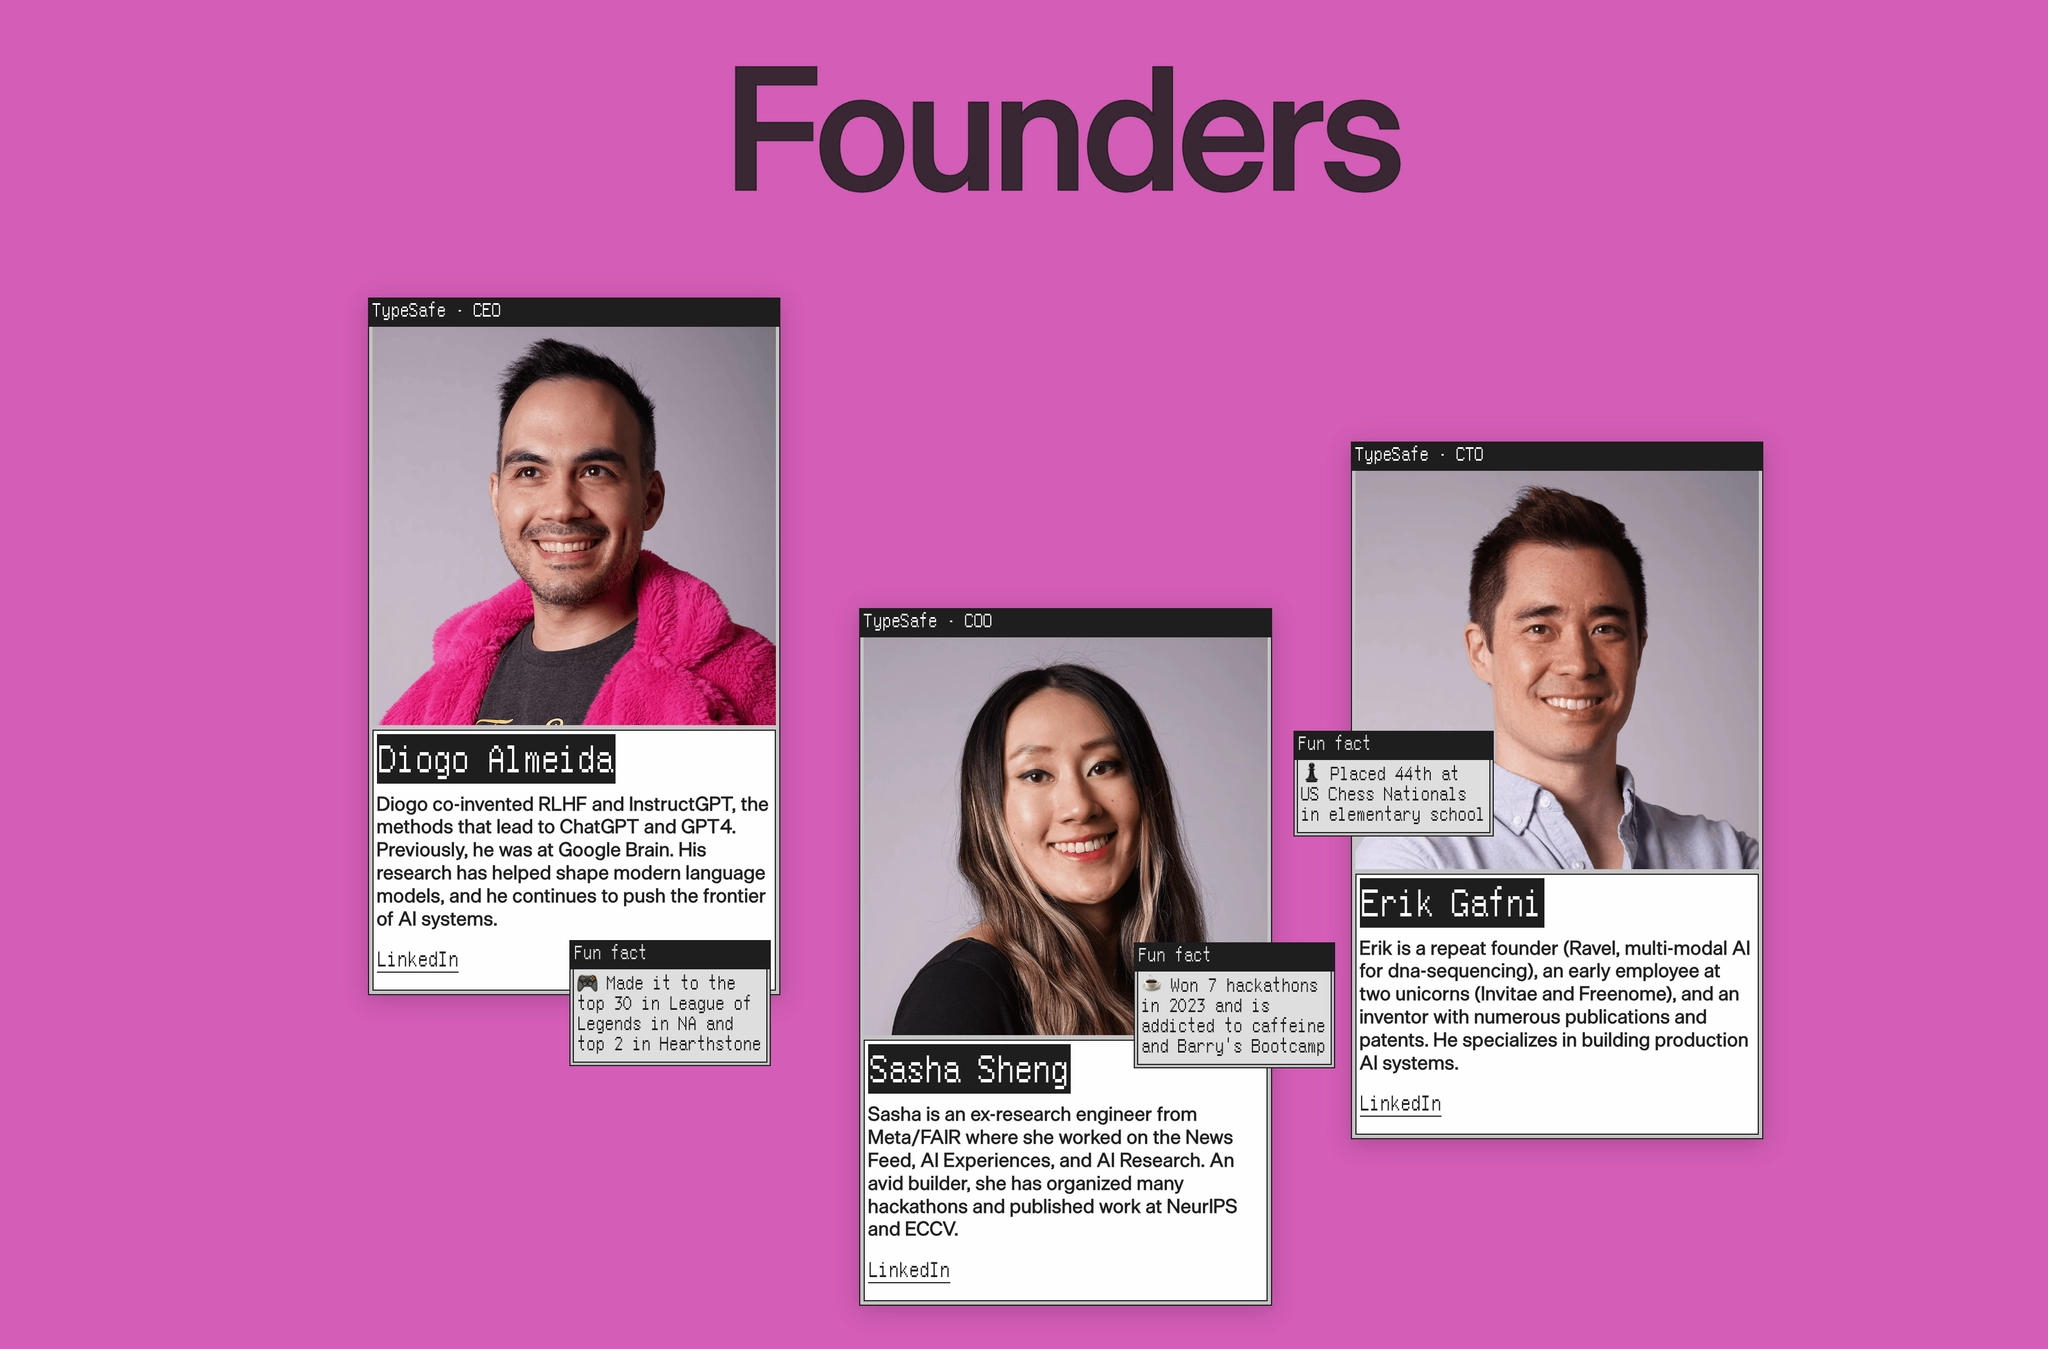
CEO Diogo Almeida : 曾任职于 OpenAI 和谷歌,参与过 InstructGPT 和 ChatGPT 的核心项目工作。官网称其为 RLHF 和 InstructGPT 的共同发明者。
核实发现: 在 InstructGPT 论文中,其名字排在第四位,带星号标注为主要作者,ChatGPT 2022 年发布的文章中将其列入贡献名单,GPT-4 技术报告在指令遵循与 API 测评部分列出了其名字,RLHF 发明者这点不太好查,没有查到具体说法,因为涉及到非常多人的长期合作。
联合创始人兼 COO Sasha Sheng: 曾是 Meta 和 FAIR 的研究工程师,负责信息流 AI 产品和研究部分,有多模态模型研究经历。
CTO Erik Gafni: 连续创业者,曾创办过一家癌症筛查公司;背景更偏向机器学习的系统性落地,曾在 Invitae、Freenome 工作.
公司在 9 月 15 日完成了由 DCVC 领投的 4000 万美元融资。在公布融资之前,他们进行了约两年的隐形开发。
一些有意思的 Jev 案例
- 有人做了一个网站,专门来收集 Jev 这个模型的一些案例。
- 一些比较饱受批评的负面案例,是让 Jev 在 Agent 中帮忙选择模型和对上下文进行压缩。很多反对的人认为它没有经历过相关的训练,同时它的模型能力也不够,而且它也并不知道这些模型和这些压缩相关的知识,所以用它来做这种事情,可能就会产生比较负向的效果。
- 使用 Jev 来编排 3D 角色的整个表演,嘴、眉毛、眼睛、脸颊、目光和身体:每条消息十个决策,实时组合成一个连贯的反应。没有预设表情。
- 基于 Jev 的一个实时的 UI 界面生成演示。
- JEV board,一个基于 Jev 模型做的手机键盘:你在输入框中输入对应的问题,在你不知道答案的时候,它就会直接弹出对应的 UI 来给你展示。你选择以后,它就会将你的问题替换为对应的答案。
- 实时的卡路里追踪器:你在左侧输入今天中午吃的食物和分量,它就能在右侧实时给你输出精准的卡路里和能量数据。
- 预测性的电子表格:你只需要在表头列输入"紧急程度",它就会对下面所有任务快速做出判断,直接给出对应的紧急程度。处理几百条数据只需要 100 毫秒,非常快。
- 把 AI Agent Jev(负责选工具)搭配轻量模型 Mercury 2.5(负责生成参数),通过 WebMCP(网站主动暴露的工具接口)跑自家浏览器基准测试,结果解决了 100% 任务,模型成本比用”截图+电脑操作”的 GPT-6 Astra 低约 112–245 倍。
- TypeGPU + ruNNtime + Jev,通过摄像头快速地对画面中的内容进行选择和高亮。比如:你说“下雨了,你该带什么东西”,它就会高亮雨伞,你说“我要吃饭”,它就会高亮勺子。
- 基于 Pipecat 编排的实时语音系统,通过 TypeSafe AI 的 Jev动嘴就能操控界面、触发音乐生成,你可以直接语音输入,让它控制音乐中的每一个乐器的声音强度,哪些开启、哪些关闭,对整个乐曲进行审查和调整。
- 提前预测用户输入的内容,并在输入完成之前就给出对应的答案。
- 视觉参考查找器,通过自然语言进行快速、大量的图片内容查找。由于这套系统不支持多模态,所以它的每一张图片都配了一个描述,相当于对每一张图片都进行了一个转文字的操作。
- 监控下载文件夹,触发规则之后将对应的文件移到对应的文件夹中。比如说,如果下载的是发票,就将文件移动到发票专门的文件夹中。处理速度非常快。
- 输入一些模糊的单词之后,快速生成对应的配色方案。
- 实时临床咨询期间,转录文本会定期提供给 Jev,Jev 会遍历医学本体来实时分类症状、更新鉴别诊断、建议治疗方案并识别危险信号。
- 实时的病毒式帖子分析器。一旦你停止打字 0.5 秒,它就会分析病毒式潜力。
- 利用 JEV 写的自动驾驶算法演示。
- 浏览器扩展,可以根据自然语言隐藏/折叠 X 上的帖子。它快到几乎察觉不到,而且极其便宜……这肯定是“广告拦截器”和内容防火墙的未来。
- Jev 可以通过并行预测每个像素来画图。
启发了学界,类似的模型
它们这几天爆火,是因为本身的训练方式和输出结果其实比较容易复刻。虽然达到相当的能力不容易,但训练一个小模型相对还是非常快速的。
由于 GPT-6 这种能力的提升,很多公司开始训练这类模型:
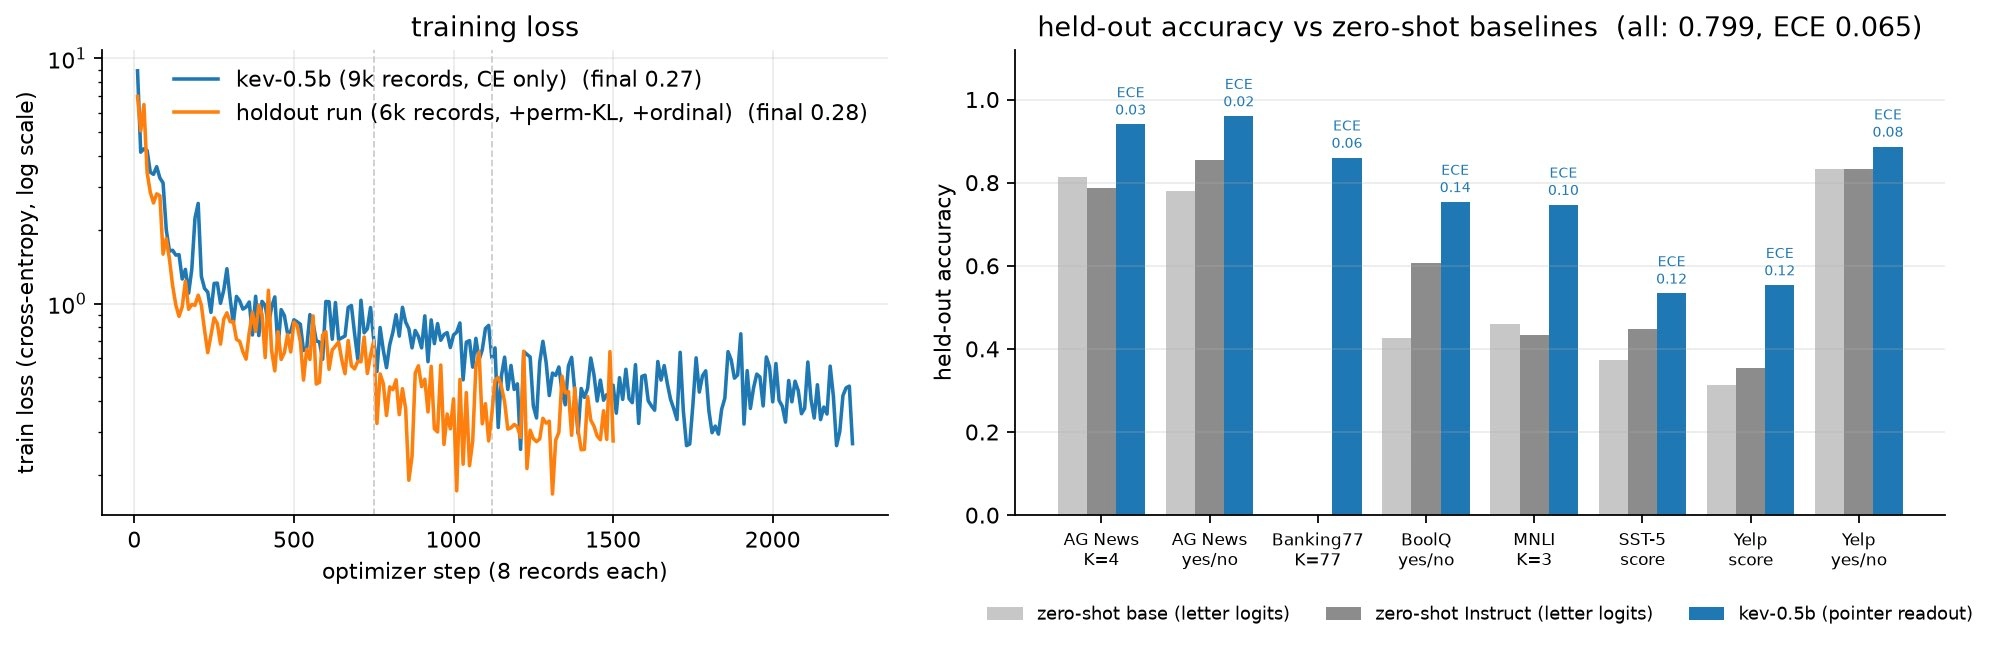
Devin:原来做 AI 编程的这家公司训练了一个叫 Kev 0.5B 的模型,带有与 TypeSafe 兼容的 API,基于 Qwen2.5-0.5B(更正为 0.5B)进行后训练。主要优势在于它只有 0.5B,所以直接在 MacBook Pro 上就能进行训练和微调。
CUA:训练了一个叫 CUA-S1 模型,专为 computer use 打造。他们会有多个模型系列,目前也开源了第一个,叫 CUA-S1-formers。