
🆕 专题一 产品新功能/新版本
1. Rancher v2.15 监控模式调整:只负责 Grafana 仪表板和 Rancher UI 集成,用户自行部署监控运行时
Rancher v2.15 新监控模式实践:使用 kube-prometheus-stack 与 Monitoring Dashboards 监控 K3s 集群
Rancher v2.15 之前的版本,是通过一个完整的 rancher-monitoring chart 统一部署 Prometheus、Grafana、Alertmanager 以及相关导出器。在新版本 v2.15 中,Rancher 引入了更加“解耦”的 rancher-monitoring-dashboards chart,用于承载 Grafana 仪表板和 Rancher UI 集成,而真正的监控运行时则需要由用户自行部署 kube-prometheus-stack,再由 dashboard chart 进行接入。
这种调整的核心意义在于:Rancher 不再把“监控运行时”和“仪表板能力”绑定在同一个 chart 中,而是让用户能够更灵活地选择自己的 Prometheus/Grafana 方案,并通过 Rancher UI 统一展示监控面板。这种架构更符合现代监控栈的部署方式,也更符合官方文档中强调的 “dashboard-only” 和 “runtime-external” 设计思路。
后文以 K3s 为例展示了部署、使用、配置的相关步骤,具体见原文。
拓展阅读:Rancher v2.15 新监控模式实践:在离线环境中安装 kube-prometheus-stack
2. Red Hat OpenShift 支持 RHCOS 10
RHCOS 10 - Red Hat’s new worker node OS for OpenShift
Red Hat OpenShift 使用一种专为集群节点设计的、不可变的操作系统,这种操作系统被称为 Red Hat Enterprise Linux CoreOS(RHCOS)。该操作系统采用了与 Red Hat Enterprise Linux 相同的内核和硬件兼容性特性,并且具有极小的资源占用量。其配置完全通过 OpenShift 和基于 Kubernetes 的 API 进行管理。
从 2026 年第四季度开始,OpenShift 将在新安装的环境中默认提供该操作系统的最新版本 RHCOS 10。预计所有经过认证的独立软件供应商提供的容器和解决方案都将支持这一版本。RHCOS 10 已作为技术预览版提供在 OpenShift 4.21 和 4.22 版本中。而 RHCOS 9 则将继续适用于较新的 OpenShift 版本,至少持续到 2027 年中期。
兼容性影响:
- 升级到 RHCOS 10 的 OpenShift 节点将不再支持基于 UBI7 的容器。而那些继续运行 RHCOS 9 的节点仍然与 UBI7 兼容。
- 基于 RHEL 10 的 RHCOS 10,已经不再支持 x86_64 v2 或更低版本的指令集。
3. 使用分层零信任模式在 Red Hat OpenShift 环境中实现零信任架构
前情提要
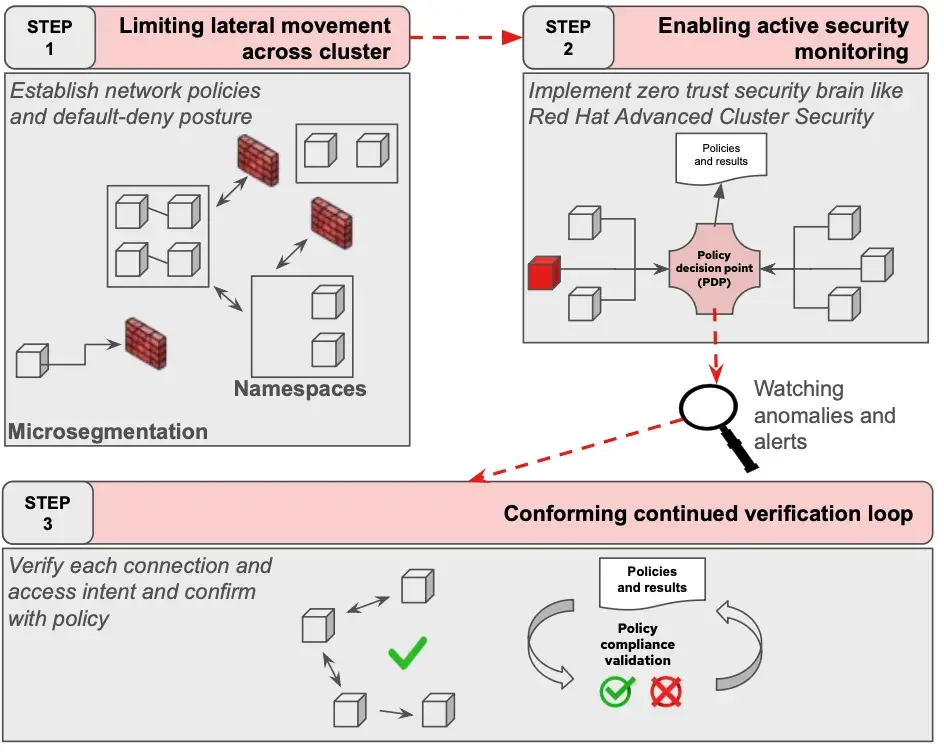
第一篇文章 Can't patch fast enough? Zero trust as a last line of defense 讨论了在组织无法快速修复漏洞时,网络策略可以作为一种最后的防御手段。展示了如何通过默认禁止访问的策略以及明确的入出规则来限制横向传播,从而控制被攻破的工作负载的影响范围。
第二篇文章 Lights on! Real-time threat response with Red Hat Advanced Cluster Security 探讨了 Red Hat Advanced Cluster Security for Kubernetes 作为主动安全机制的作用,它能够监控运行中的行为,并终止可疑的工作负载。
第三篇文章 Closing the loop: From network policy intent to verified reality 强调了一个容易被忽视的要点:明确网络策略的意图与确保策略在真实集群中按预期执行是两回事。
所有这些文章都体现了零信任安全策略的一部分,如图所示。
简介
零信任
NIST SP 800-207 将“零信任”定义为一种与传统安全架构截然不同的理念:不再因为某个资产或用户账户的位置或所有权而默认授予其信任。在访问之前会进行身份验证和授权操作,并且访问权限会持续根据具体上下文进行评估。
ZTVP 分层模型
该模式被划分为互相独立的层次。每个层次都建立在前一个层次的基础上,但功能集和用例可以根据组织的需求进行选择。
- Layer 1:Feature sets
- Red Hat Quay
- Multicloud object gateway
- Red Hat Trusted Artifact Signer
- Red Hat Trusted Profile Analyzer
- Red Hat OpenShift Pipelines
- Network observability operator and Loki operator for Red Hat OpenShift
- Layer 0:Foundation
- Compliance operator
- Red Hat Advanced Cluster Management for Kubernetes
- Red Hat Advanced Cluster Security for Kubernetes
- cert-manager operator for Red Hat OpenShift
- HashiCorp Vault
- External secrets operator
- Zero trust workload identity manager
- Red Hat build of Keycloak
当策略显式、执行点真实、结果可观测、流程可重复时,零信任才变得可操作。
使用场景
- 保护应用数据,但不在应用中加入安全逻辑
- 实现从源码到运行负载的全链路信任
- 将安全配置转化为证据
4. VMware Tanzu Platform 11.0 发布:VMware 私有 AI 云的代理平台
VMware Tanzu Platform 11.0: The Agent Platform for VMware Private AI Cloud
VMware Tanzu Platform 是 VMware 私有 AI 云的代理平台,也是 VMware Cloud Foundation 9.1 的原生平台即服务。通过将我们 CF 推送体验的简洁性直接带入 Kubernetes,解耦和现代化企业数据群,统一多区域运营,并从源代码到基础设施提供端到端安全模型,Tanzu Platform 11.0 为组织提供了构建、运行和扩展传统微服务和自主代理的信心基础。
VMware 私有 AI 云栈,顶部突出显示 VMware Tanzu 平台作为代理平台,由 Broadcom 的 AgentMinder、VMware vDefend 和 Avi 负载均衡器提供的基础设施和代理安全支持,VCF AI 服务的模型即服务,以及 VMware Cloud Foundation 的 VMware AI Factory 基础设施层。
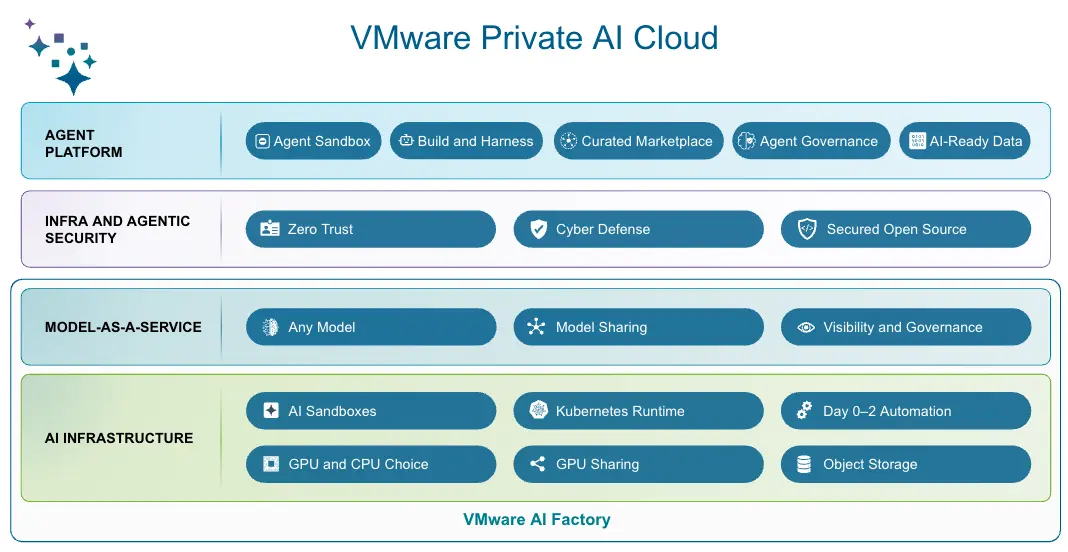
运行自主智能体需要一个为非确定性软件设计的操作模型。与传统微服务不同,代理制定动态执行计划,调用外部工具,并查询内部仓库。Tanzu Platform 11.0 增强了专门为管理和保护这些工作负载而设计的代理基础。为了实现更安全的代理自治,Tanzu 平台现提供:
- 一次性代理沙盒:每个代理都在一个独立的沙盒内执行,默认采用拒绝安全态势。沙箱环境缺乏直接的 shell 访问,无法运行任意命令行工具,并且在完成防止漏洞持续存在的任务后会被销毁。
- 隔离凭证存储:代理必须向企业系统认证才能执行工作,但暴露静态 API 密钥或在应用配置中嵌入秘密会造成不必要的暴露。Tanzu 平台通过策略驱动轮换,在隔离的凭证存储中管理代理准备的秘密。当代理通过模型上下文协议(MCP)服务器调用外部工具时,平台通过 MCP 网关直接中介连接,意味着代理和底层模型永远不会看到或处理原始后端凭证,旨在通过提示注入消除凭证泄露。
- 代理内存服务:管理复杂交互中的对话历史和会话持久性通常是一项手工定制的工作。Tanzu 平台推出了开箱即用的代理内存服务,卸载状态基础设施,使开发者能够构建上下文化的多回合代理,而无需自行配置或管理专用对话数据库。
- 模型上下文协议(MCP)工具治理:Tanzu 平台通过受控网关路由工具交互。平台团队对 MCP 服务器应用基于角色的访问控制、工具过滤和速率限制,使运行中的代理只调用经过策划的企业批准操作。
- 代理可观察性与调试:传统应用监控在排查非确定性人工智能时表现不足。Tanzu 平台引入了代理性能仪表盘、代理追踪详细视图和结构化日志。平台工程师和开发者可以追踪整个调用生命周期:检查提示输入、令牌消耗、延迟、模型上下文协议工具调用和检索上下文,从而即时定位代理为何采取了特定动作或执行卡顿。
- 新的 AI 支持数据基础:企业代理需要可信的上下文来生成准确的响应。Tanzu 平台 11.0 引入了 AI 支持的数据基础,用于管理完整的数据到 AI 生命周期,通过语义层构建和丰富多模态数据,最大化响应准确性、减少幻觉并最小化代币消耗。通过在现有企业仓库之间联合查询而无需数据迁移,团队可以将受控、可审计的数据产品直接发布到市场,供代理使用。
开发者工作流程图,显示通过单一命令推送的源代码,能够根据平台策略无缝构建和路由工作负载到虚拟机或 VKS:
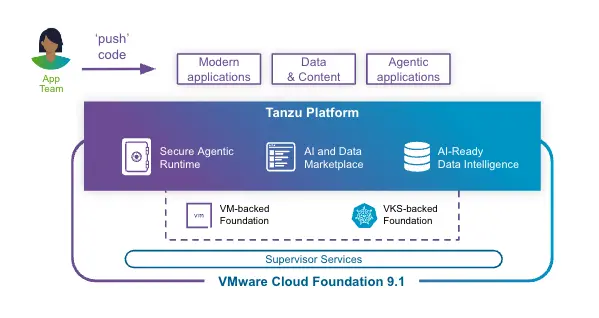
平台团队不再面临开发者生产力与基础设施标准化之间的权衡。Tanzu 平台可以按需在 VKS 或虚拟机上直接调度和运行应用工作负载。开发者继续使用标准命令、应用清单和构建包工作流。他们无需编写复杂的 Kubernetes YAML 清单、管理 Helm 图表或与 kubectl 交互。
无论平台工程师选择何种运行时,Tanzu 平台都能持续为企业提供在企业规模和可用性下运行应用和服务所需的能力。这包括零停机滚动更新应用及底层基础设施、基于金丝雀的部署、定制边车、任务执行、日志和指标导出,以及动态应用安全组等功能。
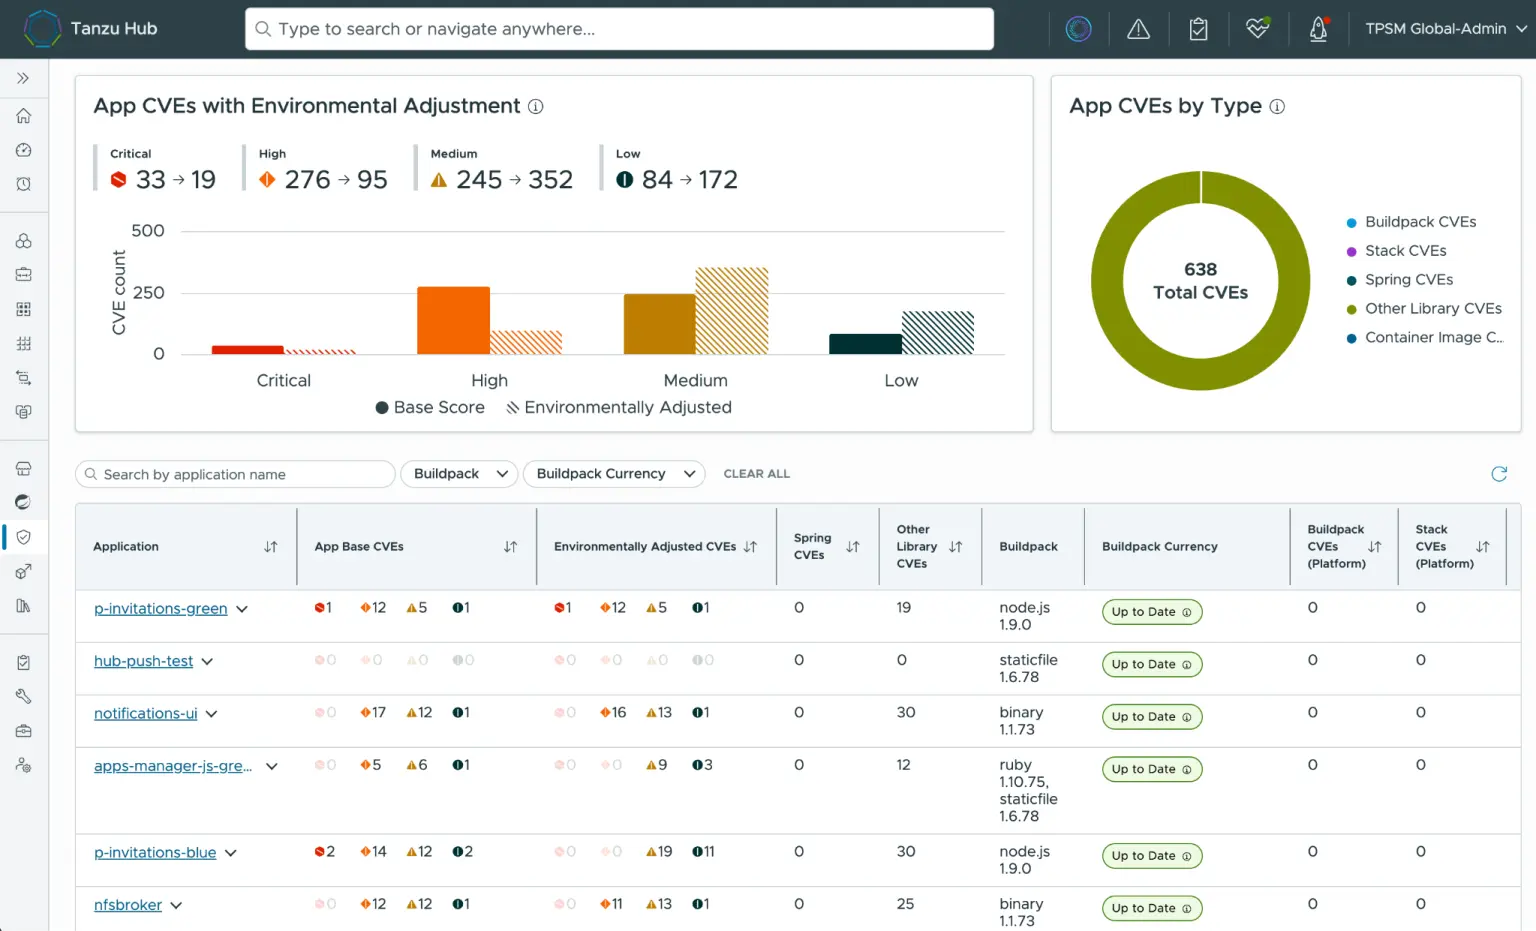
Tanzu 平台利用 CVSS 关于环境调整的理念,通过评估其实际执行的主动安全控制措施的脆弱性:
- 默认拒绝出口:大多数远程代码执行漏洞利用有两个步骤:触发漏洞,然后返回获取负载或从命令控制服务器获取指令。通过应用安全组,Tanzu 平台会阻止并监控应用容器的出站网络流量,除非明确允许路由。依赖回调的漏洞仍然存在于软件包中,但利用链在第二步就被破坏了。平台调整后的得分反映了这一差距。
- 非权限、非根容器:许多高严重度 CVE 假设攻击者可以从应用进程升级到主机。在 Tanzu 平台上,应用程序作为非特权用户在一个受限的系统调用表面容器内运行,包括 seccomp 配置文件、AppArmor 或 SELinux 以及被放弃的功能。容器内的根节点不等于节点上的根节点。影响取决于权限提升或主机访问的 CVE 会根据该边界重新评分。
- 入侵感知漏洞优先级:默认情况下,所有公共路由都需要为任何应用实例配置。对于具有公共路由的应用实例,每个请求都经过平台管理的入口,并彼此隔离路由。如果应用没有公共路由,它就不会受到大量漏洞的影响。这体现在环境对 CVE 严重度的重新评分中,允许在只突出功能上易受攻击的工作负载时进行更高的优先级排序。
VMware Tanzu Platform 与 vSphere Kubernetes Service (VKS) 是上层应用平台(PaaS)与底层容器运行时/基础设施(IaaS/K8s Runtime)的关系:
- VKS 负责底层的 Kubernetes 集群生命周期管理、计算/存储/网络资源的配给以及底层容器运行时的稳定。
- VMware Tanzu Platform:是构建在 VCF 之上的高级平台即服务(PaaS)。它为开发者和运维团队提供应用部署、Agentic AI 运行环境(如 AI 沙箱、MCP 网关)、应用级安全治理、数据服务绑定以及可观测性。
📰 专题二 新闻与访谈
1. 云原生管理平台 Meshery 晋级 CNCF 孵化项目
AI 生成的 YAML,谁来把关?云原生管理平台 Meshery 晋级 CNCF 孵化项目
Meshery 简介
Meshery 是一个自助工程平台,是开源的云原生管理器,能够设计和管理所有基于 Kubernetes 的基础设施和应用(多云)。作为一个可扩展的平台,Meshery 提供可视化和协作的 GitOps,让你摆脱 YAML 链条,同时管理 Kubernetes 多集群部署。
功能:
- 基础设施生命管理:Meshery 负责管理您的云服务和 Kubernetes 集群的配置、部署和运行,同时支持数百种不同类型的云原生基础设施集成。Meshery 支持 380+ 集成。
- 多集群与多云:Meshery 提供单一的管理平台,用于管理跨任何基础设施的多个 Kubernetes 集群,包括各种云服务提供商。Meshery 实现了在整个 Kubernetes 环境中的一致配置、运行和可观察性。
- 可视化管理基础设施:采用以 GitOps 为中心的方法,可视化且协作地设计和管理你的基础设施和微服务。Meshery 智能地推断了每种资源之间的相互关联方式。Meshery 支持组件间的多种内置关系,你可以用这些关系创建自己的自定义关系。
- 工作空间:团队用于云原生项目的 Google Drive。
- 性能管理:Meshery 提供负载生成和性能特性分析,帮助您评估和优化应用和基础设施的性能。
Meshery 的社区成长
Meshery 最初由 Lee Calcote 和 Layer5 团队于 2019 年创建,并于 2021 年 6 月 22 日被接纳为 CNCF 沙箱项目。此后,Meshery 不断发展,将基础设施模型、设计模式与操作控制统一到一个可扩展的平台中,并宣布 Meshery v1.0 正式可用。根据此次公告,Meshery 已成为 CNCF 中开发活跃度排名第五的项目。在 2025 年 7 月 1 日至 2026 年 7 月 1 日这一年内,其代码提交量增长了 350%。
2. CNCF 新一届大使揭晓:58 名新成员从六百多份申请里脱颖而出
CNCF 新一届大使揭晓:58 名新成员从六百多份申请里脱颖而出
今年,CNCF Ambassador(CNCF 大使)项目迎来了 58 位新成员,同时也向 48 位不再继续任职的大使道别。
每一位 CNCF 大使都曾利用自己的业余时间,以不同方式为云原生生态作出贡献。有人持续参与 CNCF 项目,有人组织和筹备 Kubernetes Community Days(KCD,Kubernetes 社区日),也有人参与 Cloud Native Glossary(云原生术语表)的翻译与本地化工作。
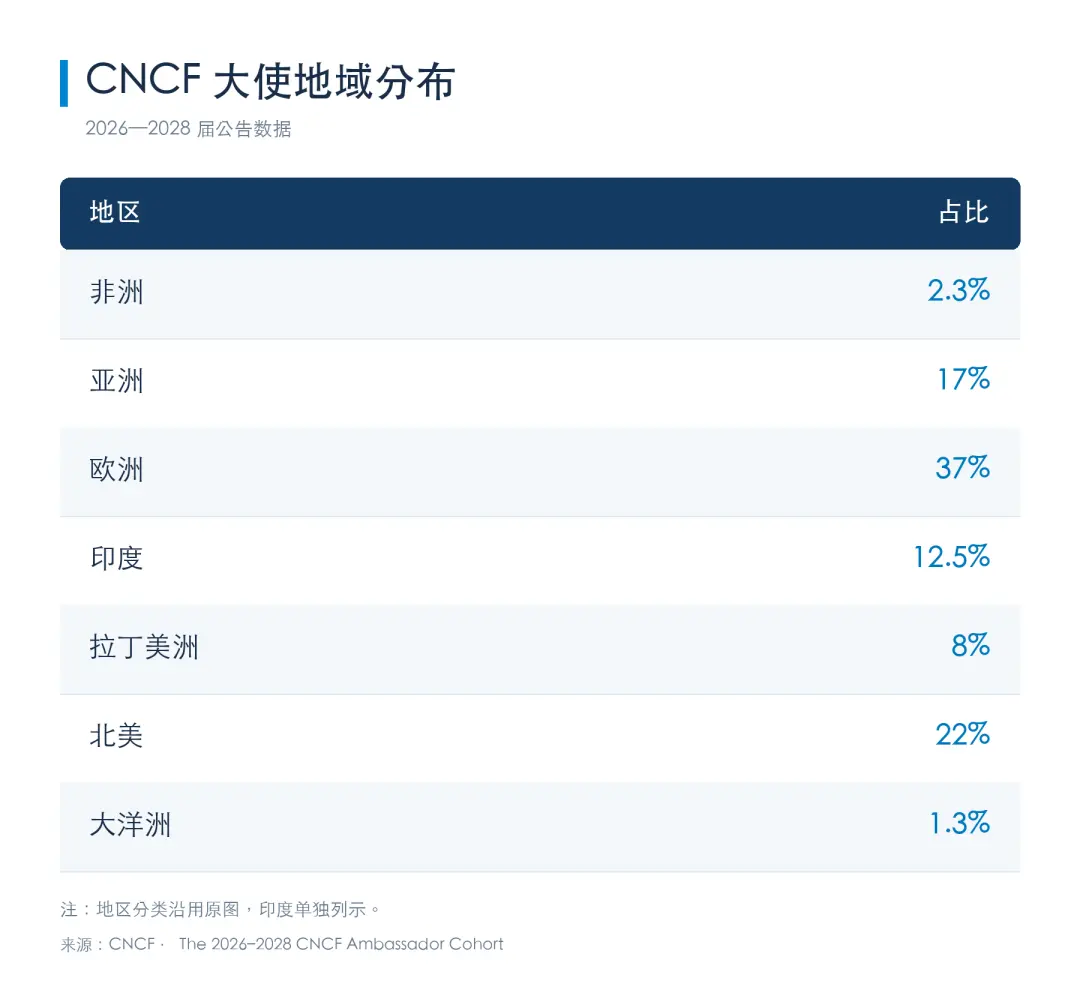
中国的大使如 Paco Xu、Jimmy Song、Jintao Zhang 是在各种博客中经常看到的。
基本要求如在 CNCF 代码或非代码仓库中有可追踪的贡献记录。属于无薪(Unpaid)志愿者角色,任期为 2 年(需重新申请)。其他评估标准有活跃的项目贡献、社区领导力、公开演讲、指导与导师身份、内容创作等。可自行申请。
3. Workload Conformance Working Group 成立
Announcing the Workload Conformance Working Group
Kubernetes 社区现在有一个工作小组专门负责制定工作负载合规性的标准。这个工作小组正在努力制定一个统一的规范,以描述工作负载在 Kubernetes 运行时的情况。
经过认证的 Kubernetes 测试会检查集群的正常运行情况,而 Kubernetes AI 一致性测试则用于判断集群是否能够运行人工智能和机器学习工作负载。对于工作负载本身来说,并没有类似的测试方法。因此,集群管理员在定期维护或升级 Kubernetes 时,仍然需要手动逐一检查每个应用程序的运行状态。
该宪章规定了三项具体目标:
- 针对每个 Kubernetes 版本的工作负载行为规范描述。
- 一种针对运行中的工作负载来测试每个需求的方法。
- 那些能够实现这些测试的下游一致性工具。
该规范规定了工作负载的运行方式,重要的是,它并不涉及工作负载的具体功能。因此,应用程序的逻辑并不属于工作负载合规性的范畴。该二进制文件无需重新测试已受 Certified Kubernetes 覆盖的内容,也不需要特定的工作负载打包格式,或者像策略引擎、安全扫描器等第三方工具的支持。
🔐 专题三 安全
本月无。
💬 专题四 讨论与分享
1. Kubernetes 向 cgroups v2 的转变:你需要知道什么
2025 Paco Xu 个人博客版:原文、2025.10 云原生相关信息简报
2026 Kubernetes 官方博客版:The Shift to cgroup v2 in Kubernetes: What You Need to Know
The New Stack HPE 赞助博客版:Kubernetes on cgroup v1 is dead. Here’s what comes next.
Kubernetes 已经弃用了 cgroup v1。从 Kubernetes v1.35 开始, failCgroupV1 默认为 true ,所以默认情况下 kubelet 不会从 cgroup v1 节点启动。管理员可以在 Kubelet 配置文件中临时设置 failCgroupV1: false ,但移除将遵循 Kubernetes 弃用策略。进一步的移除工作记录在 KEP-5573:移除 cgroup v1 支持。
如果你使用的版本比 v1.35 早,升级前先将所有 Linux 节点迁移到 cgroup v2,或者计划设置临时的 failCgroupV1: false 覆盖。如果你已经用的是 v1.35 或更高版本,确认每个 Linux 节点都运行 cgroup v2(或者你有意保留覆盖)。在默认配置下,剩余的 cgroup v1 节点在 kubelet 启动时会失败。
2. 通过节点交换扩展 Kubernetes 工作负载
Scaling Kubernetes Workloads with Node Swap
背景
内存通常是 Kubernetes 集群首先遇到的硬性限制。节点的内存耗尽远早于 CPU 耗尽,而新一代智能 AI 工作负载让情况更糟。这些工作负载需要大量内存占用,才能启动并运行不受信任的代码,然后闲置等待下一个提示。
管理员在配置内存密集型工作负载时常面临一个持续的困境:设置过高的内存限制会导致昂贵的基础设施浪费在空闲内存上;设置太低,可能会导致记忆不足(OOM)击杀。
方案
通过使 Linux 内核能够将匿名内存分页到磁盘,节点交换在流量激增或内存过度订阅期间起到缓冲作用。
历史上,Kubernetes 不鼓励交换,原因有两个。第一个是记忆核算。在 cgroup v1 中,控制项将内存和交换视为单一的合并限制,而非允许操作员单独设置磁盘交换的限制。如果没有独立的跟踪,进程可以将大量匿名内存分页到磁盘,这使得容器的真实内存使用变得不可预测且难以隔离。Kubernetes 的交换支持通过依赖 cgroup v2 解决了这个问题,cgroup v2 独立的交换会计单独跟踪磁盘交换。第二个原因是分页到转速较慢的磁盘带来的延迟损失,而高速 NVMe 本地 SSD 在很大程度上消除了这种延迟。这些因素共同使得增加舱体密度和缓冲内存峰值变得切实可行,同时不牺牲集群稳定性。
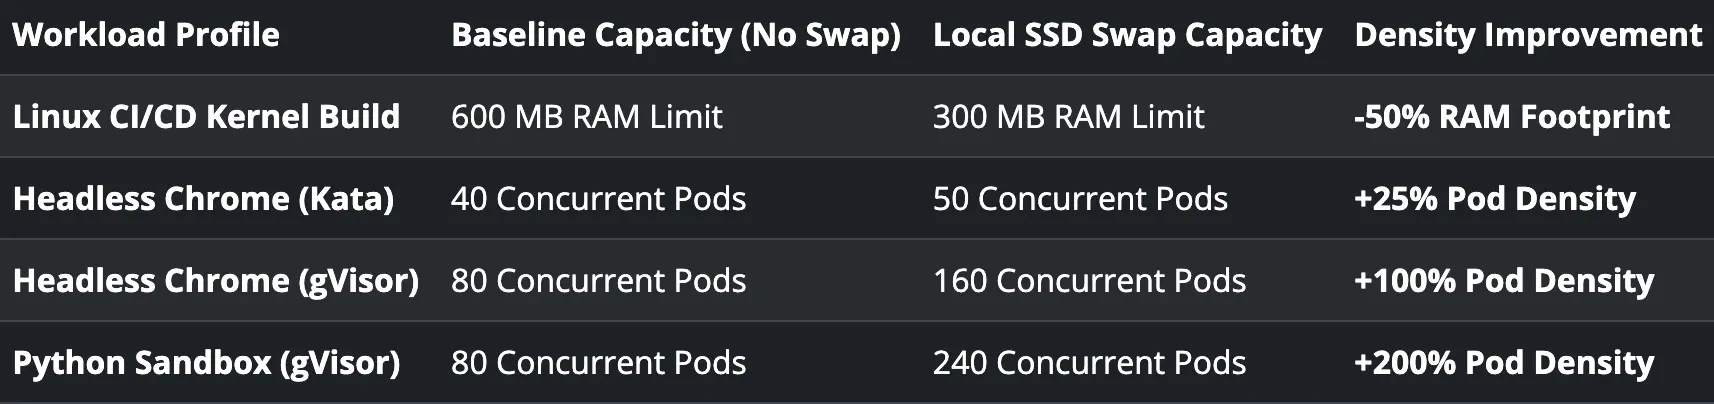
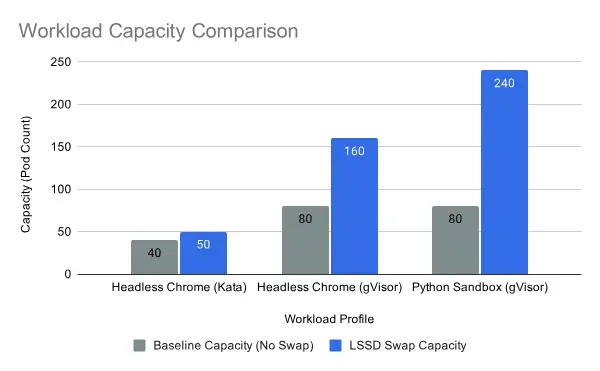
使用方式
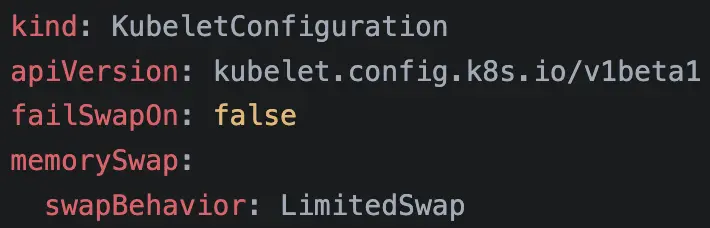
在 Kubernetes v1.34+ 中,可以通过 kubelet 配置来启用它:
3. Kubernetes 灾备最危险的误区:有备份,为什么还是恢复不了
Kubernetes 灾备最危险的误区:有备份,为什么还是恢复不了
简介
本文介绍三个故障场景,用来区分“拥有备份”和“能够恢复”,并说明每个场景带来的实践建议。
相关概念
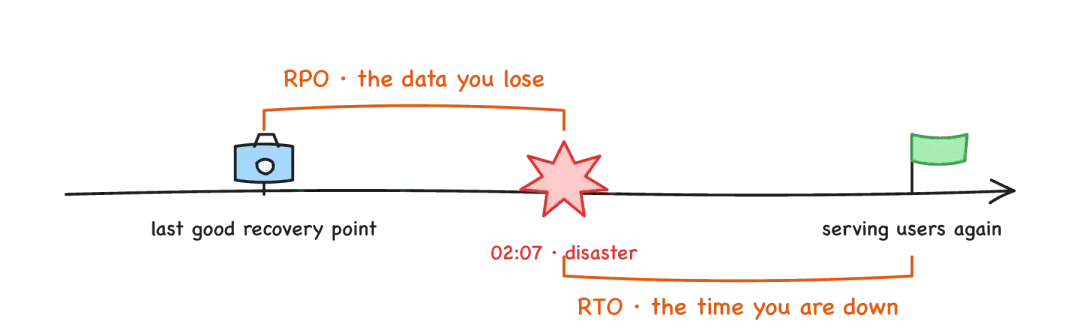
从最近一个可用恢复点到灾难发生之间的时间差,对应可能丢失的数据范围;从灾难发生到重新为用户提供服务,则对应停机时长。
- RPO(Recovery Point Objective,恢复点目标):关注能够容忍丢失多长时间范围内的数据。
- RTO(Recovery Time Objective,恢复时间目标):关注能够容忍多长时间的服务中断。
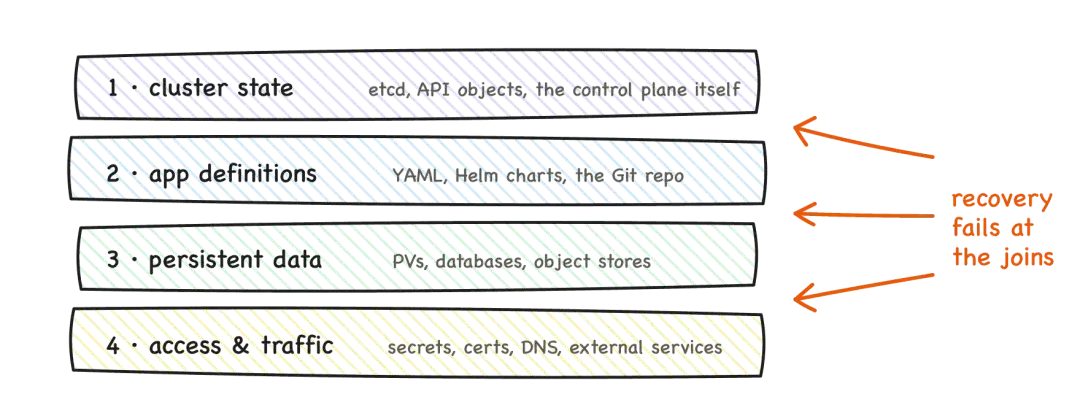
恢复的四个层次:
实验环境
整个实验由两个集群和两个服务组成,全部在本地运行:
- 生产集群:一个 Kubernetes 集群,每个节点都是拥有独立内核的轻量级虚拟机。因此,模拟生产环境丢失,就是关闭一台机器。
- 恢复集群:第二个 Kubernetes 集群,在故障发生之前就已经存在。
- 备份存储:位于两个集群之外、兼容 S3 的对象存储。这样,任何一个集群丢失,都不会连带丢失恢复点。两个集群中的备份工具都指向同一个存储桶。
- Git:一个保存应用清单的本地 Git 服务,由恢复集群中的 GitOps 控制器持续监控。
实验工作负载是一个 PostgreSQL 应用,包含已知的四行数据。因此,每次恢复都可以与预期结果进行比对,而不只是观察监控面板是否变绿。
场景一:验证备份中确实包含数据
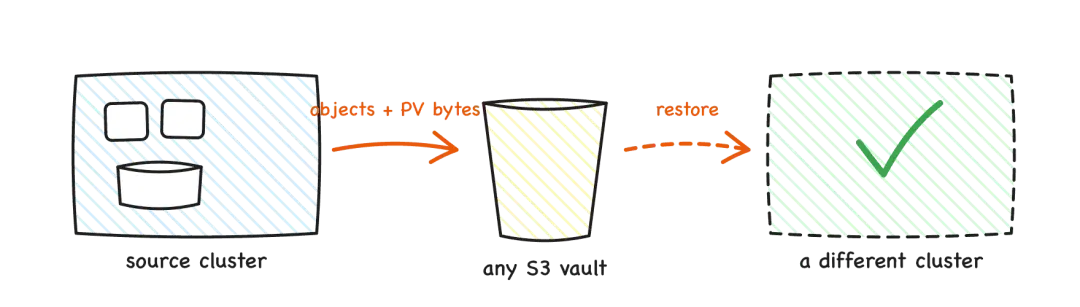
Kubernetes 备份包含两个不同部分:资源定义,也就是 YAML,以及持久卷中的数据。
责任边界: 备份工具会把资源恢复到一个已经存在的集群中。它们不会创建集群、节点、网络、负载均衡器或 DNS。必须由其他机制恢复 Kubernetes 本身,例如基础设施即代码(IaC)或 Cluster API。
如果一份灾难恢复计划从“恢复备份”开始,就必须明确:备份究竟要恢复到什么环境中。
场景二:声明状态不等于已存储状态
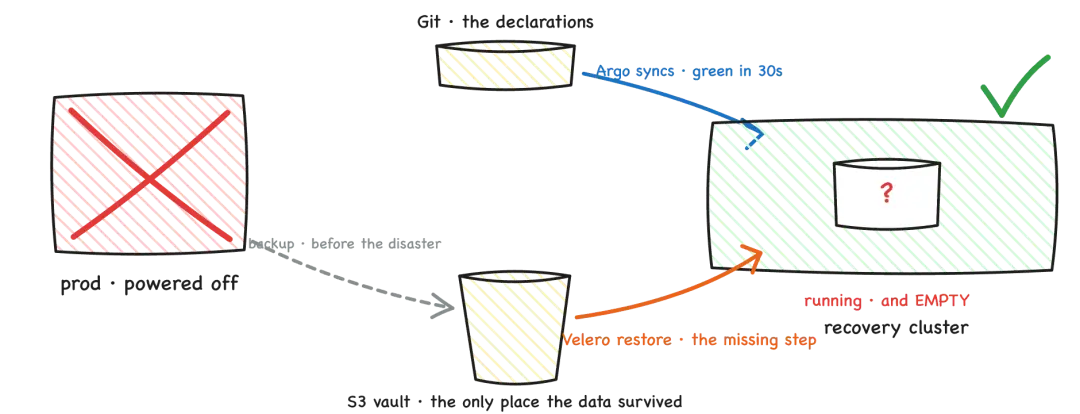
没有任何组件发生故障。Git 中始终只有声明,因此 Kubernetes 完全按照 YAML 的要求执行:创建 StatefulSet、创建 Service,并为 PVC 配置一个全新的空卷。GitOps 完美重建了声明状态,却没有恢复任何已存储状态。
两类工具都不可缺少,因为需要恢复的是两种不同的内容,而每类工具只负责其中一种:Git 保存意图,备份保存状态。
场景三:多卷一致性
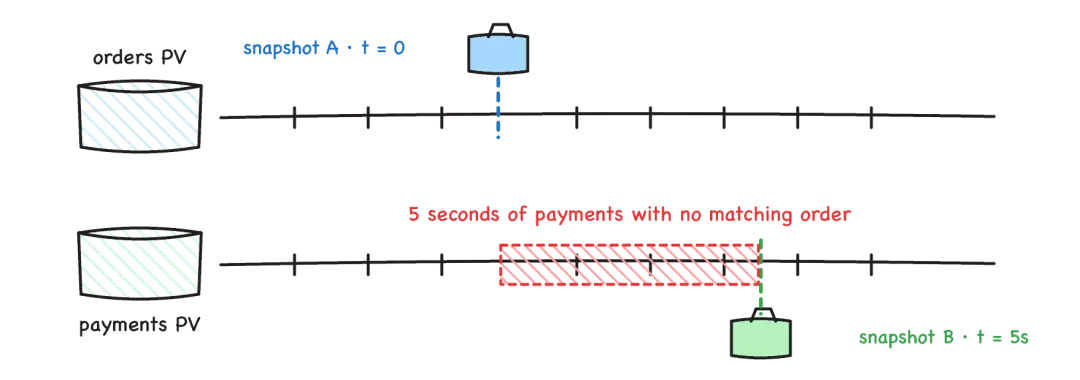
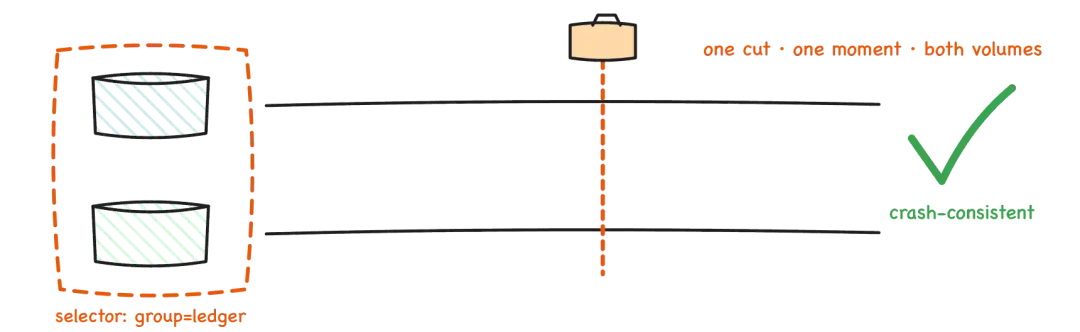
真实的有状态应用往往跨越多个存储卷,例如数据库数据与预写日志(WAL)、消息代理分区,以及副本集。
VolumeGroupSnapshot 在 Kubernetes 1.36 中进入正式可用阶段(GA)。一个对象通过标签选择 PVC,CSI 驱动接收一次请求,为所有选中的卷创建一个经过协调、具备崩溃一致性的恢复点。
恢复测试建议
删除一个 Pod,再观察它自动重建,并不属于恢复测试;那测试的是工作负载的调谐能力。真正的恢复测试应该:
- 将完整的有状态应用恢复到一个此前从未运行过该应用的干净目标环境。
- 根据预期内容验证数据和用户访问链路,而不只是检查资源状态。
- 对整个过程实际计时。
以下架构原则可以直接从实验应用到生产环境:
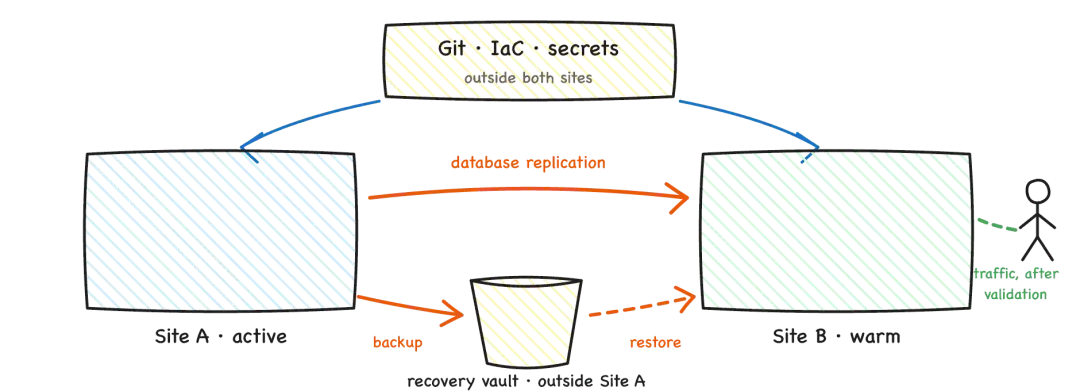
图中,站点 A 为当前提供服务的主站点,站点 B 为温备站点。Git、基础设施即代码和密钥位于两个站点之外;恢复存储库位于站点 A 之外。数据可以通过数据库复制同步到站点 B,也可以从备份存储恢复。流量应在验证完成后再切换到恢复站点。
生态中尚待解决的问题
- 缺少通用的跨集群故障切换约定。数据、工作负载、集群、流量和身份都有各自的工具,但每一层都缺少与下一层共同遵循的衔接约定。各产品在自己的 API 内部解决这些问题,而 Kubernetes 核心并未定义完整顺序。
- 缺少标准化的应用恢复单元。Kubernetes 核心没有一个持续维护的 Application 资源,用来声明哪些对象、Operator、数据服务和外部依赖必须一起恢复。备份工具使用命名空间和标签,GitOps 控制器有自己的应用对象,包管理器使用 release,各自划定的边界并不相同。
- 备份成功被当成了恢复能力的证明。备份完成指标普遍受到监控,恢复演练结果却很少被纳入监控。
4. 通过 VKS 周边产品优化 CI/CD 流程
介绍角度
从超大型云提供商(如 AWS)迁移到本地私有云 VKS 不需要从头开始重建交付管道。因为,VMware Cloud Foundation 能够实现公共云原生架构与本地私有云架构之间的功能对等性。
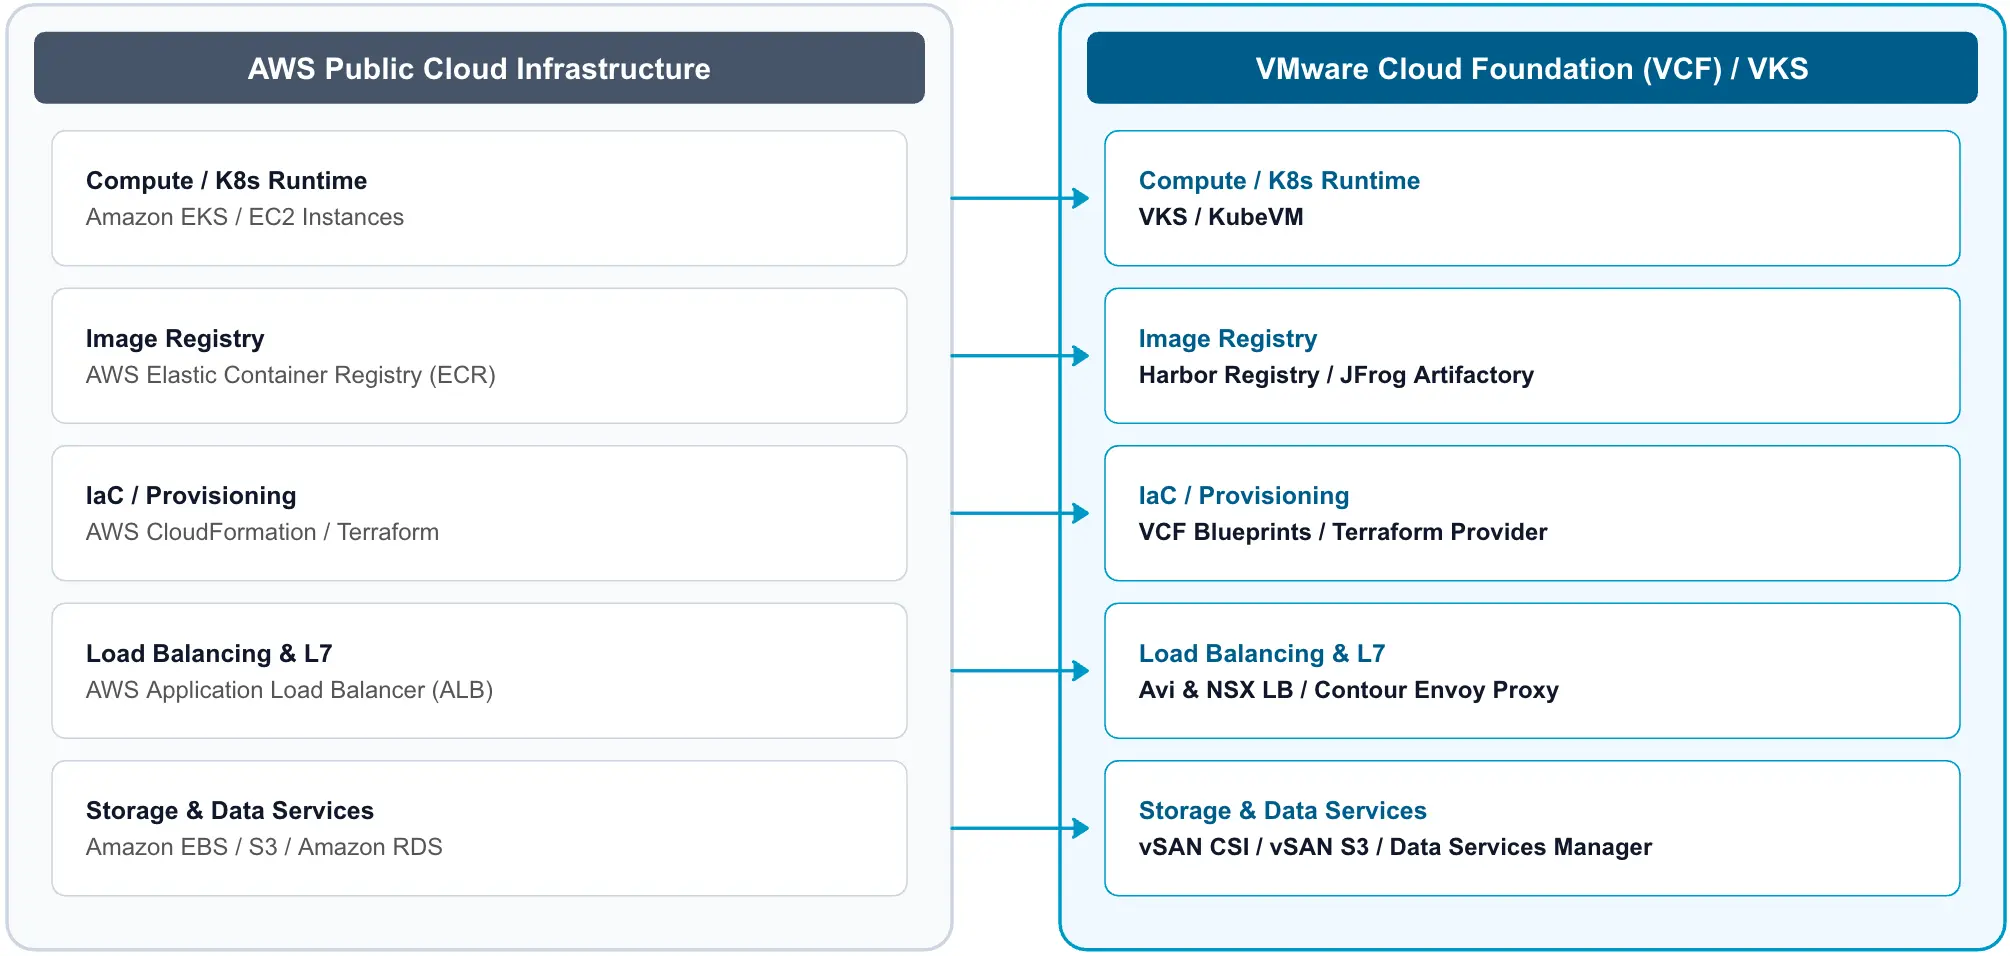
关键技术:Supervisor 架构和半虚拟化技术
VCF 的核心组件是 vSphere Supervisor。通过直接在 vSphere 控制台上展示声明式的 Kubernetes 自定义资源定义,vSphere Supervisor 能够将这些声明式的 YAML 配置文件转化为实际的 VMware 基础设施资源,从而无需开发者直接干预 vCenter 用户界面即可完成操作。
当请求到达 Supervisor API 服务器时,专门的控制器会负责协调资源的实例化过程。
- VKS Controller 和 VM Operator:将 Cluster API 规范转换为 vCenter API 调用,从而配置用于控制面和工作节点的虚拟机。
- 网络插件和 Operator(CNI 及 AKO):通过与 NSX 和 Avi 负载均衡器对接,能够动态分配 IP 地址、配置 VPC 子网,并发布 L4/L7 负载均衡器的虚拟 IP 地址。
- CSI Controller:将持久性卷绑定到 vSAN 存储策略中,为客户端集群工作负载提供半虚拟化的存储访问权限。
关键组件/产品
为了实现一个安全且自动化的软件供应链系统,该蓝图整合了六个核心生态系统组件,这些组件在双 VKS 集群中协同工作。
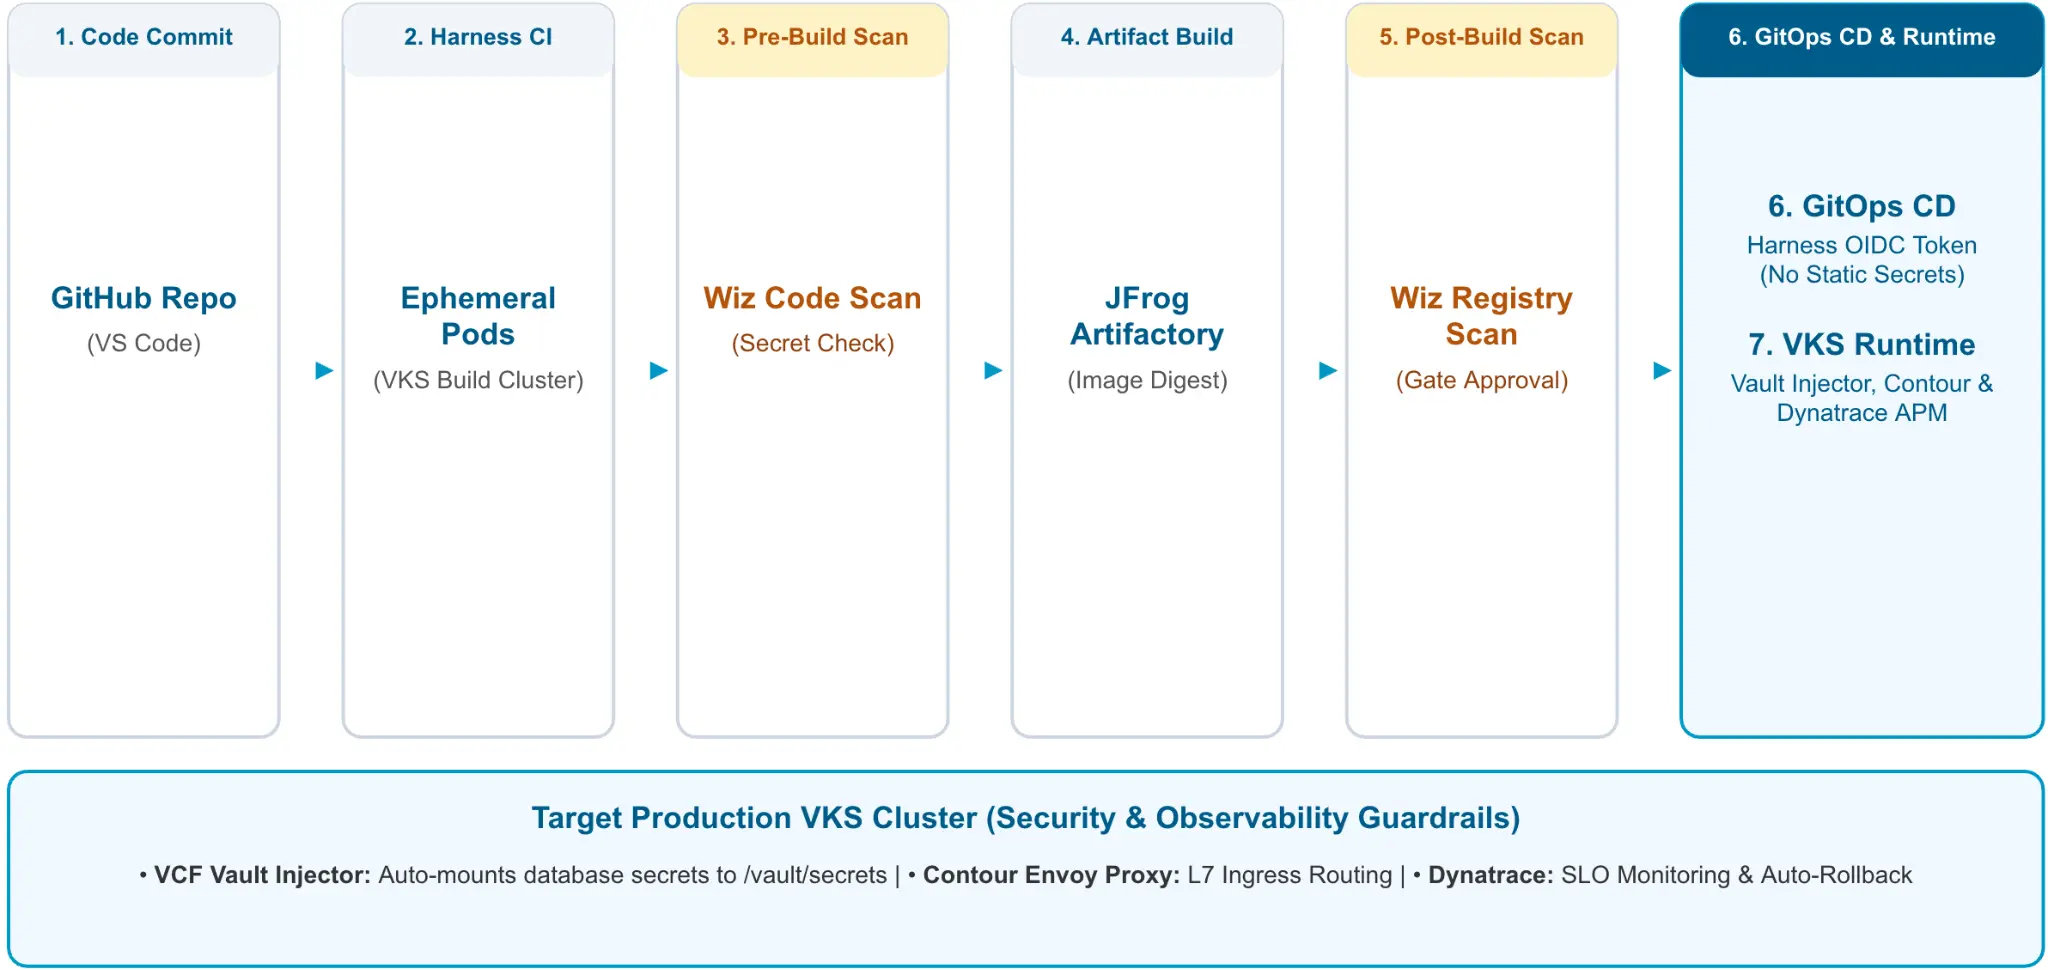
- GitHub:微软旗下的代码托管平台,这里作为源码仓库,代码提交后通过 webhook 触发整个流水线。
- Harness:CI/CD 平台,Harness CI 负责构建、Harness CD 负责部署,通过 Harness Delegate 执行。文中它承担临时构建 Pod 调度、OIDC 短时认证和 SLO 违规时的自动回滚。
- JFrog Artifactory:制品仓库(可存二进制和容器镜像),这里存放构建出来的容器镜像,供后续扫描和部署拉取。
- Wiz:云安全平台,这里作为两道安全门 —— 构建前扫源码静态漏洞和密钥,构建后从 Artifactory 拉镜像做逐层漏洞扫描,通过后才允许 CD 放行。
- Dynatrace:可观测性和应用性能监控(APM)平台,这里做全栈实时遥测,当部署的 SLO 被破坏时触发回滚,形成闭环护栏。
- VCF Secret Store:VCF 集成的密钥管理能力(基于 Vault),配合 VKS Vault Injector 在 Pod 创建时把数据库凭据动态注入到内存的 /vault/secrets,避免密钥写进 Git 或镜像。
- NSX:VMware 的网络虚拟化,这里负责 VPC 子网和网络策略。
- Avi Load Balancer:VMware 的负载均衡组件,负责动态分配 IP、配置 L4/L7 负载均衡的虚拟 IP。
- vSAN:VMware 的分布式存储,这里给 CSI 提供持久卷。
- Contour + Envoy:Kubernetes 入口网关,Contour 是控制面、Envoy 是数据面,用 Gateway API 把外部流量路由进集群。
关键的架构创新
- 双集群拓扑结构与临时构建节点:Harness CI 利用专门的 VKS 构建集群。构建过程通过临时性的 Kubernetes 节点来执行,这些节点在完成后会自动终止,从而避免了工作区的污染,并减少了攻击面的风险。
- 构建集群(VKS Build Cluster)专门承接 CI 任务。Harness CI 把每次构建步骤跑成短生命周期的临时 Pod,任务一结束 Pod 就自动销毁。演示里这些临时构建 Pod 被调度到构建集群里一个专门的 NS-01 命名空间。
- 生产集群(VKS Production Cluster)承载真正的应用运行时。Harness CD 拿到短期 OIDC token 后,对生产集群里的应用命名空间执行滚动更新部署。
- 确保使用 OIDC 认证(无需使用静态 Kubeconfig 文件):为了消除在 CI/CD 平台中嵌入静态 Kubeconfig 文件或集群管理令牌的风险,博通和 Harness 共同开发了 VKS OIDC 集成方案。Harness Delegate 会从企业身份提供者处获取一个短期的 OIDC 身份令牌。目标 VKS 生产集群会动态验证该令牌,在令牌失效之前授予临时的 RBAC 授权。
- 双阶段安全门系统:在编译之前,预构建的 CLI 会扫描源代码中的静态漏洞和秘密信息;在构建之后,还会从 Artifactory 直接下载容器镜像,以在授权 CD 升级之前验证基础镜像层是否完好无损。
- 通过 VCF 密钥存储库进行运行时密钥注入:部署到 VCF 密钥存储库中的工作负载可以直接从集成在管理工具中的 VCF 密钥存储库获取敏感的数据库密钥。VCF 密钥注入器能够拦截容器创建过程,将密钥动态挂载到/vault/secrets 路径下的内存中,而无需将密钥持久化到 Git 或容器镜像中。
拓展阅读
Managing VMware vSphere Kubernetes Service Clusters at Scale: Improvements in VCF 9.1
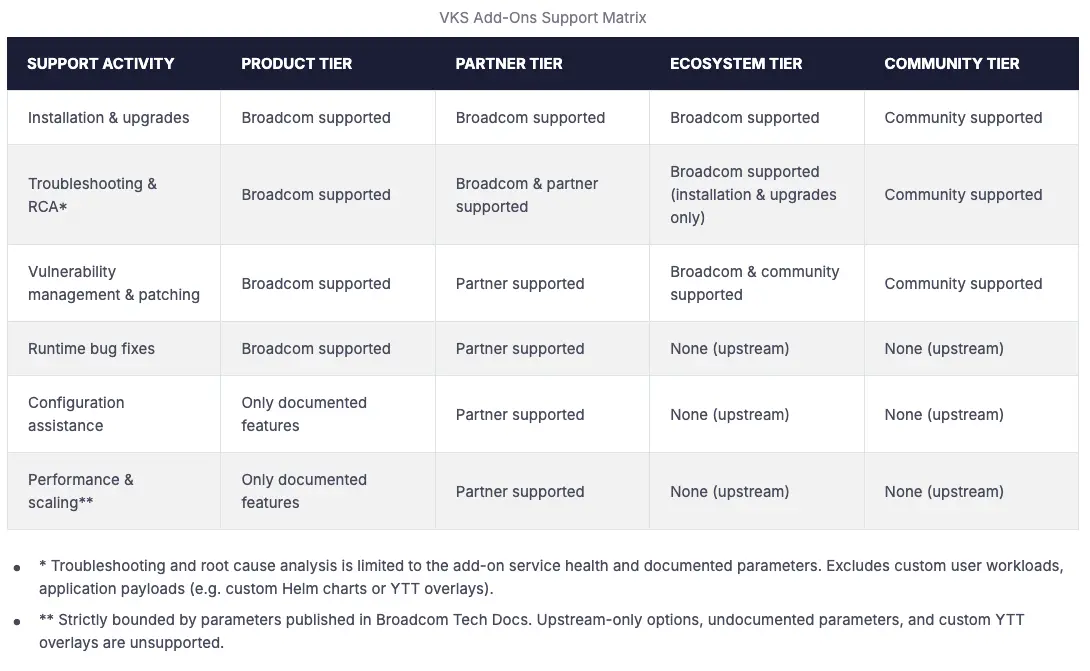
VKS Add-Ons 中不同角色的职责边界:
- Product(产品):由博通公司的工程师们精心设计和整合而成。博通全球支持服务涵盖了从部署、升级到运行中的故障排除等整个生命周期中的需求。
- Partner(合作伙伴):由某独立软件供应商策划。Broadcom GS 负责部署和生命周期管理;您的独立软件供应商则负责运行时相关的问题处理。
- Ecosystem(生态系统):由 Broadcom 策划,经过开源验证,确保与基础 VKS 兼容。Broadcom GS 的服务涵盖了软件包管理和生命周期管理,但不涉及上游的漏洞问题。
5. 利用 Amazon Bedrock AgentCore 实现 AI 驱动的 EKS 迁移评估
AI-powered EKS migration assessment with Amazon Bedrock AgentCore
背景
应用搬到 EKS 之前,需要有人回答“它准备好了吗”——读代码、梳理依赖、找出会阻碍迁移的问题、估算工作量。手工做这件事又慢又难以保持一致:每个应用耗时随复杂度波动,不同评审者结论不一,还容易漏掉硬编码配置、有状态依赖、不适合直接映射到 Kubernetes 的存储模式这类后期才暴露的问题。面对几十上百个跑在虚拟机或其他编排平台上的应用,自动化评审才能规模化。
方案简介
这个方案构建一个迁移评估 Agent:读取应用源码和容器制品,产出一个就绪度评分、按严重程度排序的阻塞项清单,以及带 EKS 目标架构建议的迁移计划。它与 AWS 现有迁移服务互补 —— Migration Hub 做组合级跟踪、Application Discovery Service 做基础设施发现、AWS Transform 打包容器、Konveyor 做规则分析,而这个 Agent 更进一步,直接读源码,用 FM 理解代码语义,找出发现工具会漏掉的细微阻塞,如本地文件系统状态、平台特定认证、会话粘性假设等。
支持平台
Red Hat OpenShift、Azure AKS、本地 WebSphere/JBoss/WebLogic、自管 Kubernetes、Docker Swarm。
评估覆盖类别
应用代码、密钥与凭据、存储与卷、网络与入口、认证授权、消息与集成、数据库与状态、上下游依赖、定时任务、资源规格、容器安全、可观测性、平台特定项。
报告结构
当前状态、迁移就绪度评分与按严重程度排列的阻塞项、建议、目标服务映射、迁移工作量与时间线、迁移手册(按“修复阻塞→容器化→K8s 清单→部署验证”分阶段)、风险评估、目标架构。
成本
单次评估约 0.18 到 0.57 美元(Bedrock token、AgentCore 计算时间、S3、DynamoDB 加总),常驻基础设施约每月 96 美元(ECS Fargate、ALB、NAT 网关、WAF、CloudWatch Logs)。
6. 为需要严格隔离的 AWS 工作负载提供安全、自动化的容器镜像仓库管理机制
Automating secure container registry management for air-gapped AWS workloads
背景
在金融、医疗保健、政府和国防等受严格监管的行业中的组织,通常会将容器注册表管理在隔离的 AWS 环境中。
这种隔离方式也带来了实际问题。在任何一个应用程序能够运行之前,基础设施团队需要将所有的依赖项都迁移到私有环境中。对于典型的 Kubernetes 环境来说,这意味着需要将数十到数百个 Helm 图表和容器镜像从公共和私有源注册表迁移到私有的 Amazon Elastic Container Registry 中。然而,仅仅复制这些文件是不够的。团队还需要配置每个仓库,以实施相同的安全控制措施:使用客户管理的密钥进行加密处理,保持镜像标签的不可变性,加强扫描功能,以及设置合适的生命周期规则。
人工方式的局限性
- 安全性的偏差。当每个存储库都是手动配置或通过临时脚本来设置的时,就会出现一些小的不一致性。这些错误在当时看来似乎并不严重,但这些不一致性在后期很难被发现。在一个需要向审计人员展示一致性的控制策略的环境中,这种不一致性本身就已经构成了风险。
- 加密默认值。许多受监管的机构要求在 AWS 密钥管理服务中使用客户管理的密钥,这样他们就能控制密钥的策略、轮换以及访问权限。这一点看起来似乎很简单,但实际上非常重要,因为一旦仓库创建完成,其加密配置就无法更改了。如果操作出错,就只能创建一个新的仓库,然后重新迁移图像。
- 多架构镜像的处理。拉取异构镜像可能需要一段时间才能被发现。
- 私有注册表认证。实际环境中并不会只从 Docker Hub 获取资源,还会从 Harbor、JFrog Artifactory 以及其他私有 ECR 注册表中提取资源,这些注册表各自拥有独特的认证信息。如何安全且可靠地处理这些认证信息,而不将它们硬编码到脚本或配置文件中,这是一个相当棘手的问题,稍有不慎就可能导致错误。
AWS 的方案:基于 ECR 仓库创建模板
通过这种模板,你可以一次性定义仓库设置,而每当创建出一个与指定前缀相匹配的新仓库时,亚马逊 ECR 会自动应用这些设置。结合 CREATE_ON_PUSH 功能,当第一次将图片推送到相应的路径时,就会自动创建一个具有正确设置的仓库。你无需事先准备数百个仓库,也无需逐一进行配置。
全流程如下:
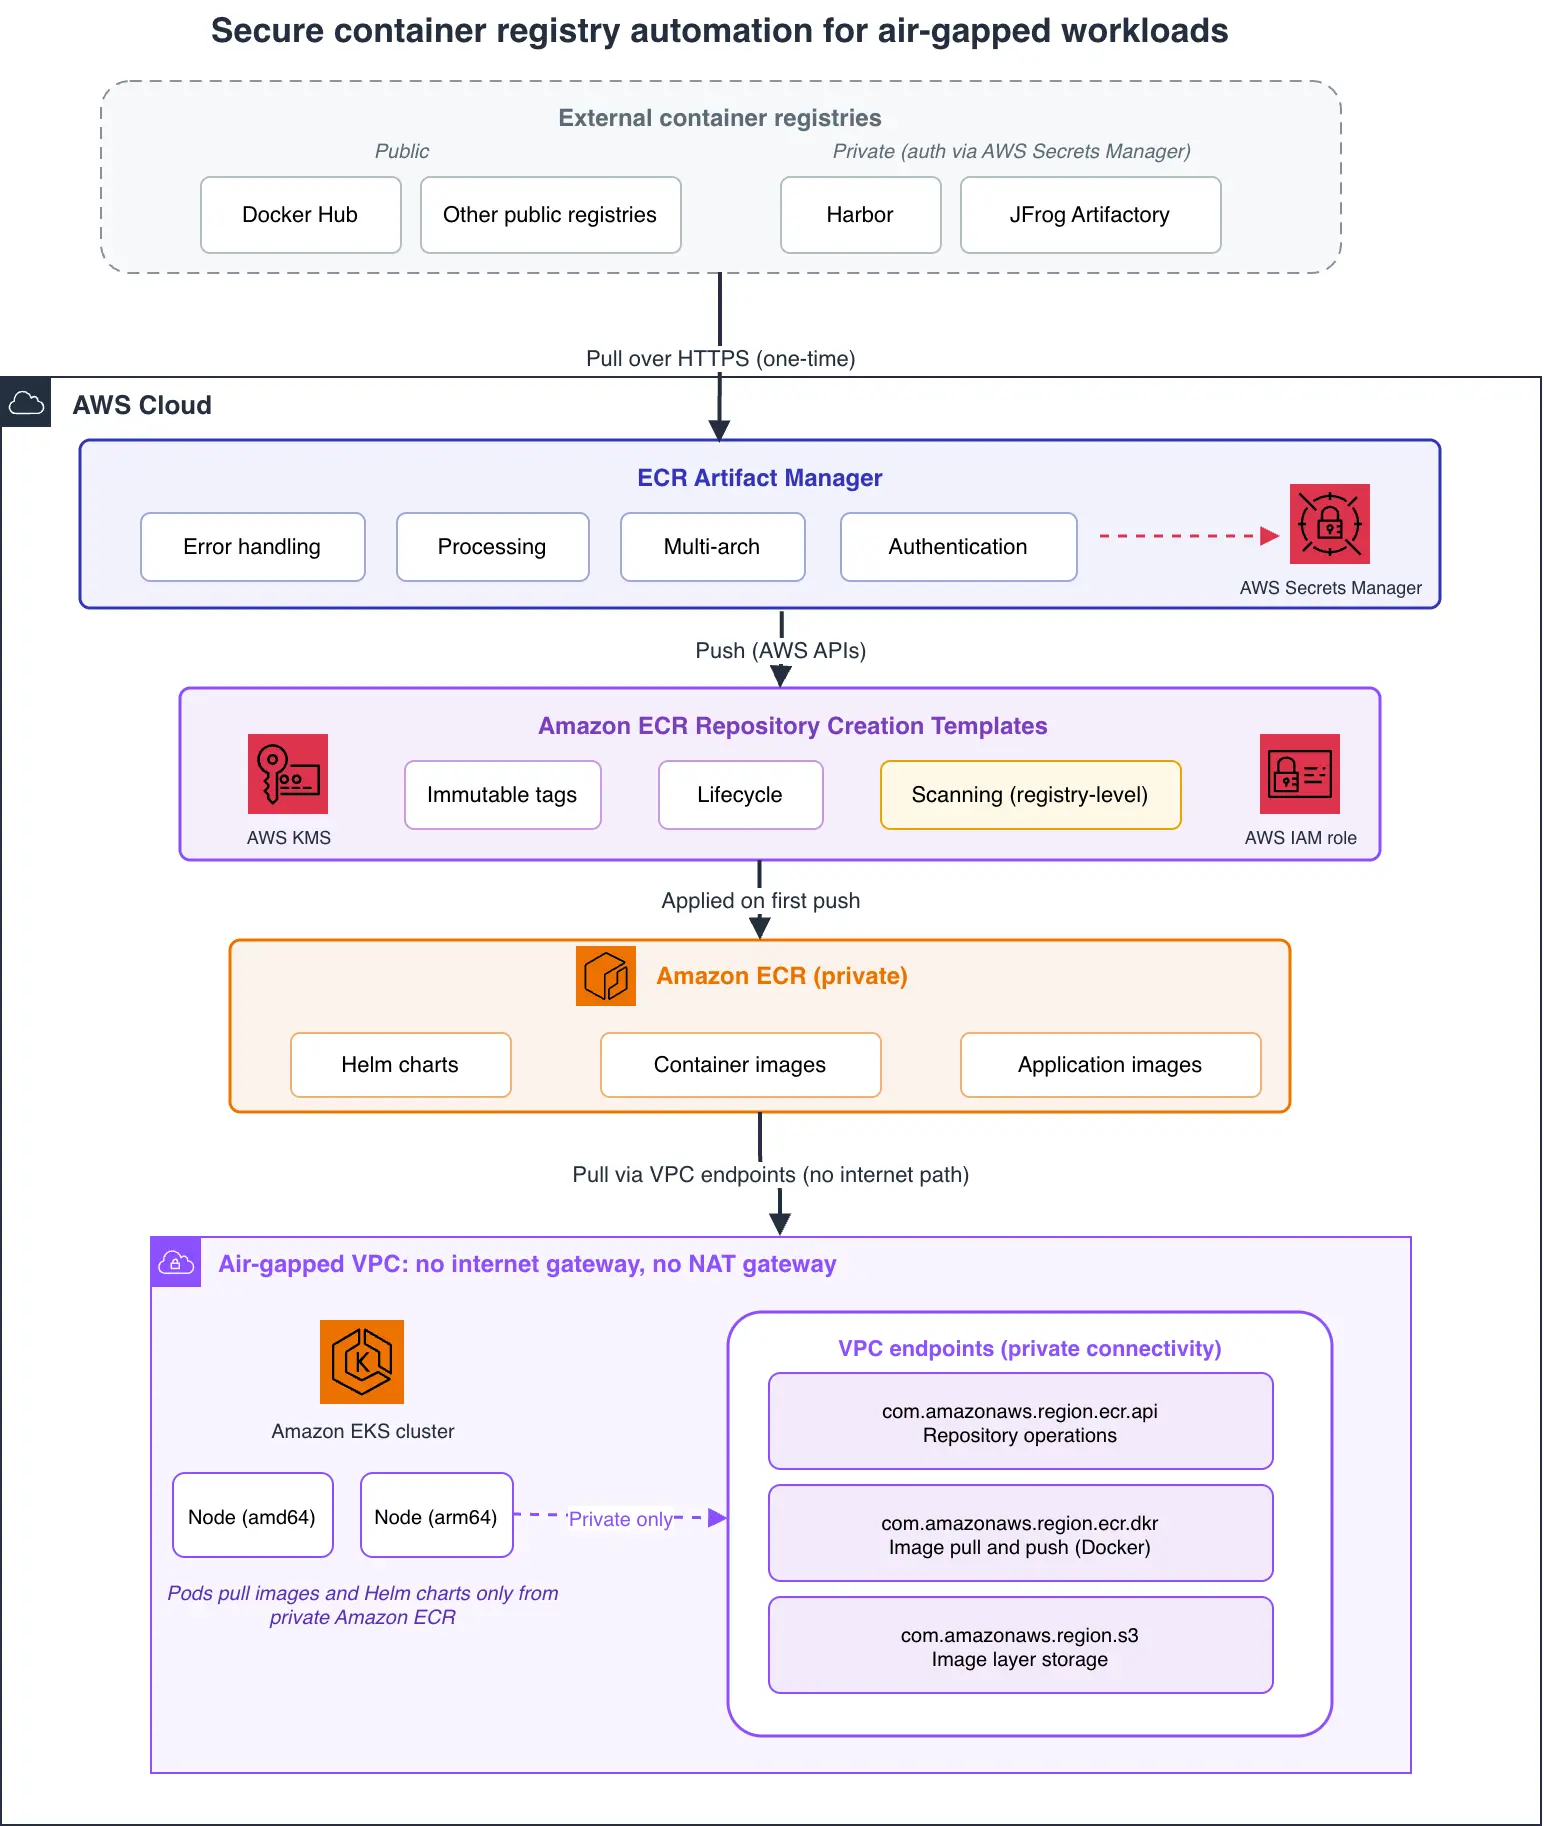
- 来源注册表。Helm 图表和容器镜像最初存储在公共注册表中(如 Docker Hub),之后才会迁移到私有注册表中(如 Harbor 和 JFrog Artifactory)。
- 迁移工具。该工具会将每个工件复制到目标账户中,同时保留多架构的清单文件,并通过 AWS Secrets Manager 进行身份验证以访问私有资源。
- 仓库创建模板。每当有工件被推送时,Amazon ECR 会根据相应的模板创建目标仓库,并自动应用由客户管理的加密、不可变标签以及生命周期规则。之后,位于隔离环境中的 Amazon EKS 集群将仅通过 VPC 端点进行数据访问。
这一重要变化是,存储库创建模板能够自动应用您的安全设置,这有助于减少配置上的差异。您仍然需要负责整体安全状况的维护,包括密钥管理和生命周期策略。该模板包含了您的标准配置:由客户自行管理的 AWS KMS 加密机制、不可更改的标签,以及用于使未标记镜像失效的生命周期策略。通过该模板创建的存储库也会完全遵循这些标准配置。
设计考虑与权衡
- 这些模板仅适用于新的存储库。
- 某些设置在创建时就是不可更改的。尤其是加密配置在仓库创建后就无法进行修改了。
- 不可更改的标签改变了团队的工作方式。这种标签提供了强大的控制能力。它们可以防止镜像标签被覆盖,从而确保所部署内容的完整性,并为您提供可靠的审计追踪。不过,那些习惯于覆盖浮动标签(如 latest )的团队需要改用到版本化标签以及升级工作流程。
- 负载均衡机制引入了速率限制。在拥有数十个仓库的情况下,限制因素不再局限于正确性,而是吞吐量问题。像 Docker Hub 这样的公共注册中心会实施拉取速率限制,而 AWS API 则会对速率进行调节。实际的解决方案包括:对源注册中心进行身份验证以提升其限制水平、批量处理工件、并行运行独立的批次任务(在合适的情况下),以及采用指数级退避重试机制,从而避免临时速率限制导致任务失败。
- 凭证的有效期是有限的。除了之前提到的 12 小时有效期外,存储在 AWS Secrets Manager 中的源注册表凭证也应该遵循一定的轮换计划。从一开始就设计好轮换机制,比后期才进行改进要更高效。
适用场景
如果你拥有的仓库数量少于十个,或者你并不处于受监管环境或封闭系统的限制之下,那么使用模板、Terraform 模块以及专门的迁移工具所带来的额外工作量可能超出了你的需求。
当许多存储库之间的一致性成为必要条件而非次要要求时,这种模式就具有了价值。
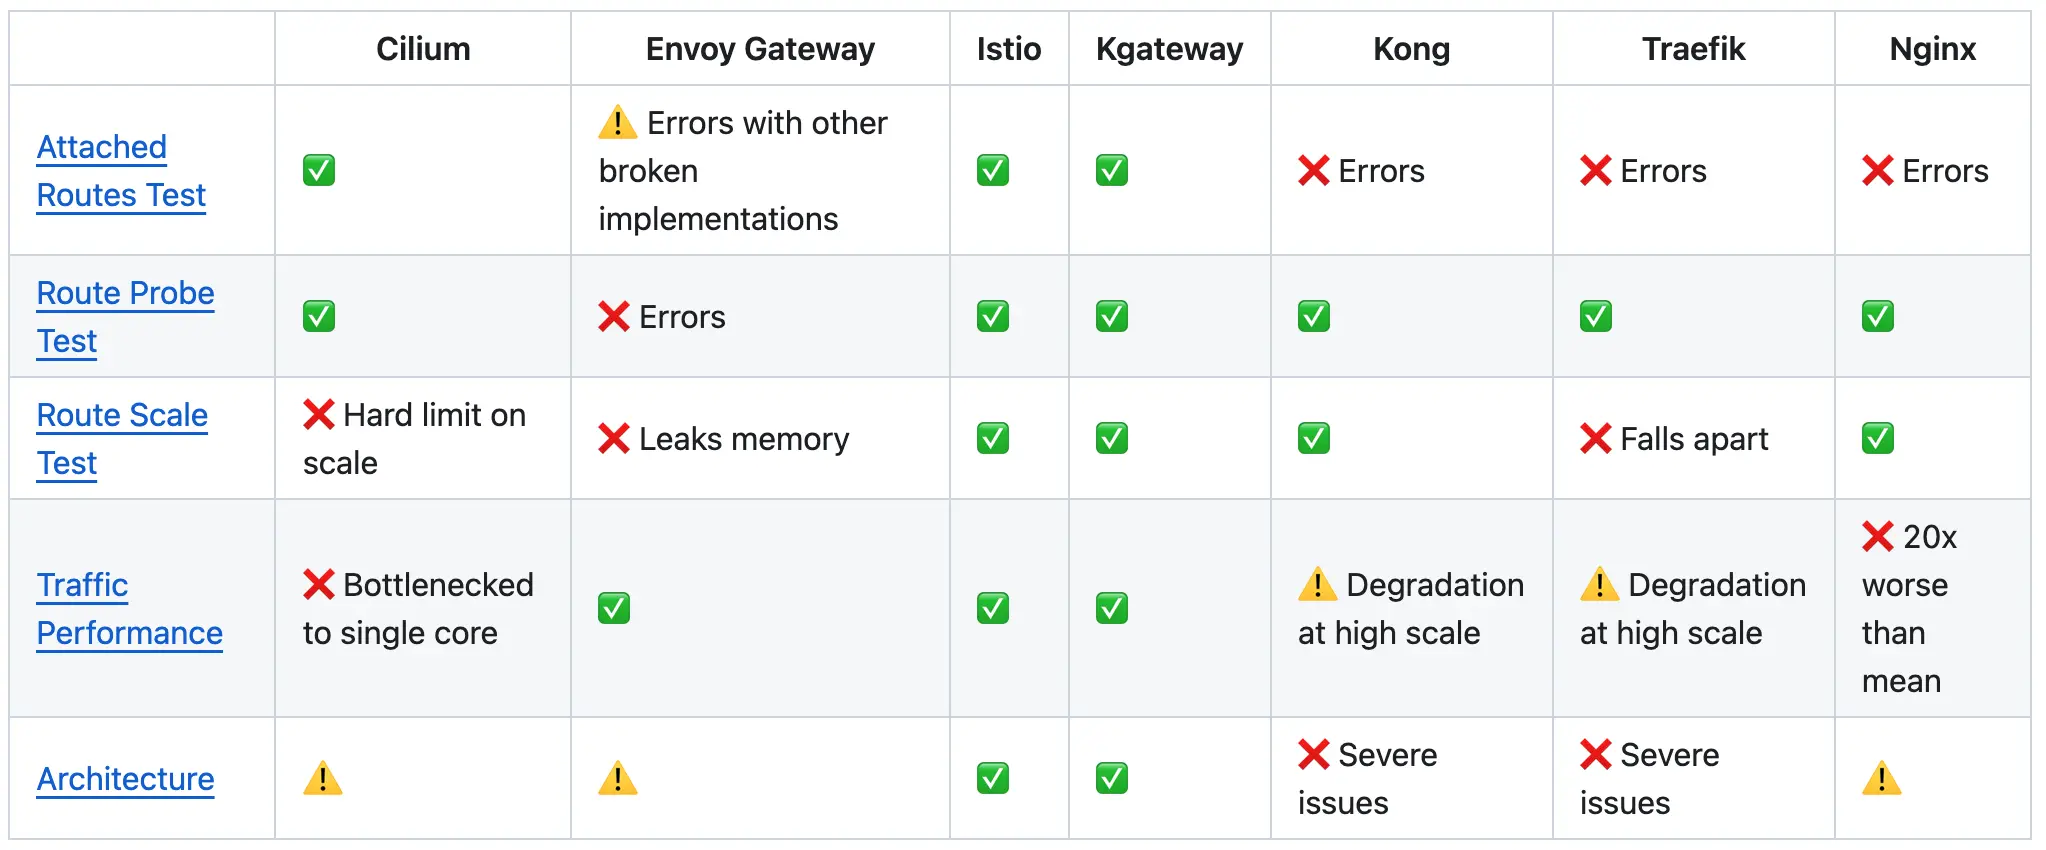
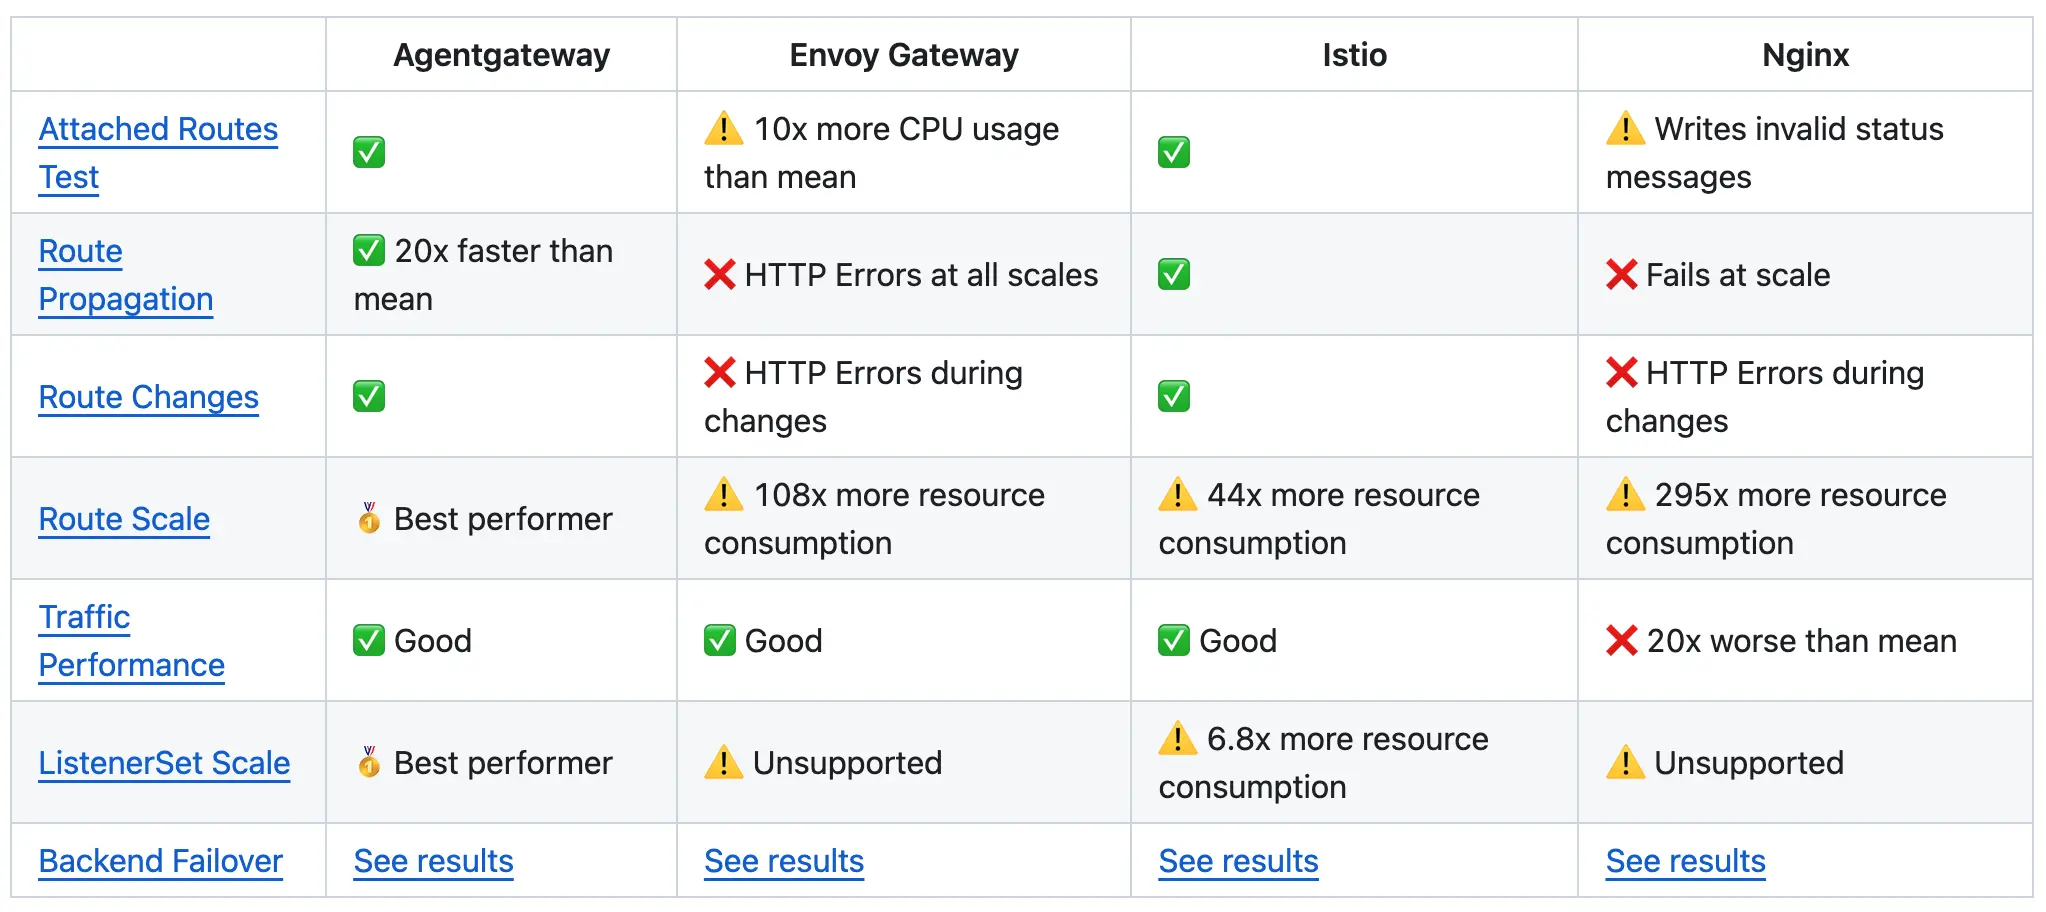
7.Gateway API Benchmarks
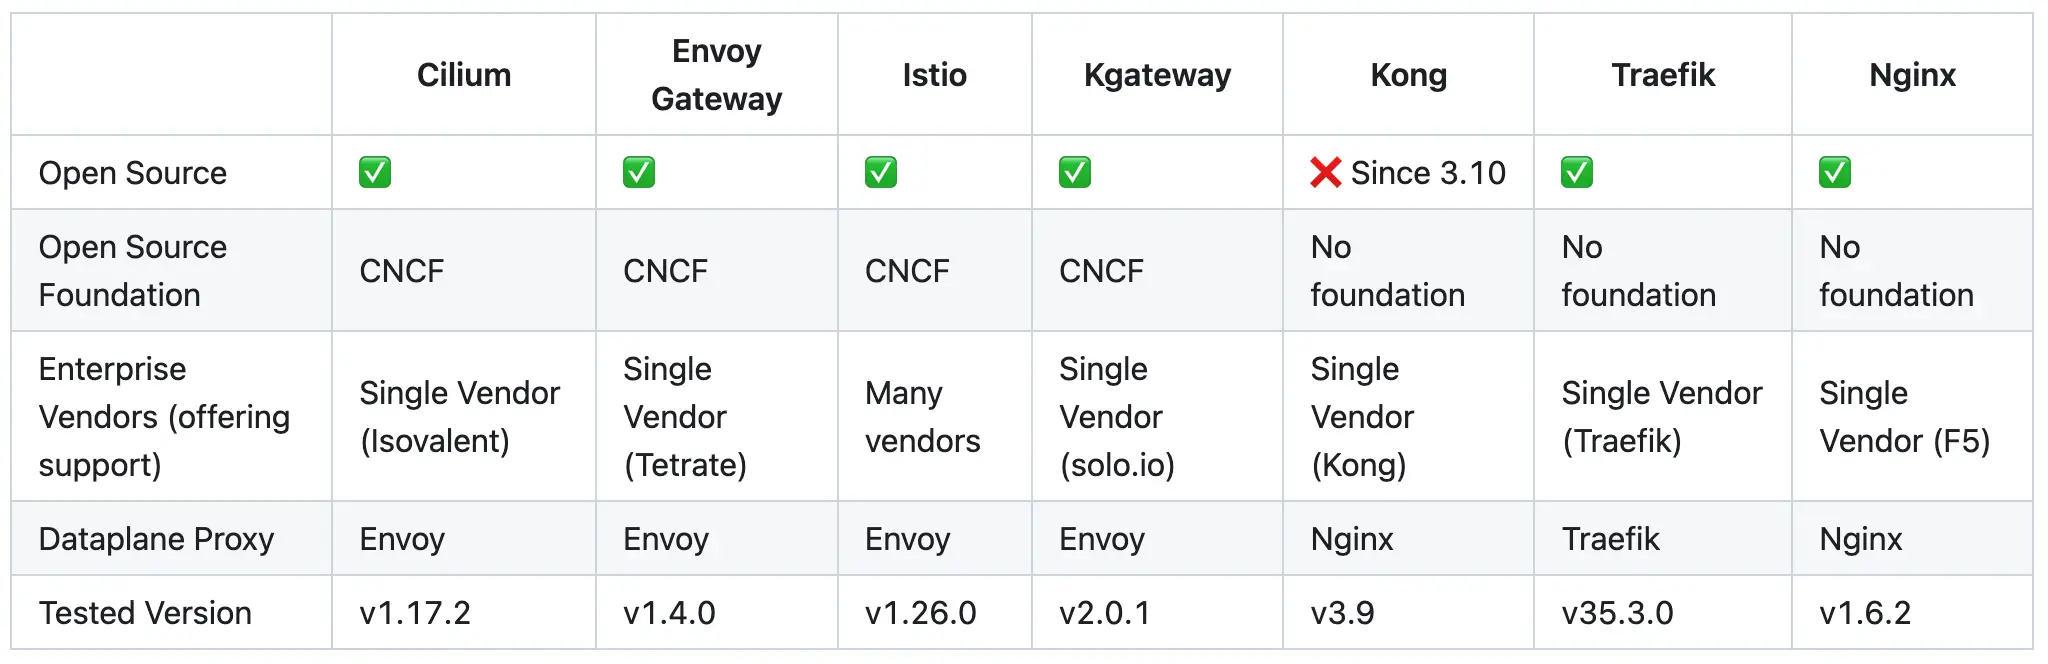
该仓库旨在提供一个全面的测试套件,远超一致性测试,帮助用户更好地理解不同实现的实际行为。
v1 版本
v2 版本
8. Kubernetes 在支持 AI Agent 中还面临哪些挑战
Is Kubernetes ready for AI agents?
挑战与问题
安全问题
尽管人工智能推理与 Kubernetes 的结合非常出色,但两者之间仍然存在一些差距,尤其是安全性方面。最近在前沿人工智能实验室发生的事件表明, AI Agent 可能会脱离测试环境,从而在互联网上发起恶意网络攻击。因此,必须采取强有力的防护措施,以防止人工智能工作负载出现异常行为。
不幸的是,人工智能的随机性特性导致我们无法准确预测人工智能任务会使用哪些资源。这就增加了代理行为超出控制范围的可能性。
行为不可控
虽然前沿 AI 实验室可能此前没有充分监控其 AI 模型的行为,甚至连模型是否联网都没严格管控。对于普通企业来说,当他们的 Agent 出现越轨或异常行为时,可没有“事后求得原谅”的资本。
随机性与响应速度
一个用户提出了问题 -> 代理开始处理 -> 执行一些操作,可能会创建其他代理,调用多个工具,然后就消失了。
从零开始创建一个 Kubernetes 工作负载可能需要几秒钟的时间。对于许多应用程序来说,这完全可以接受。但是对于一个需要交互操作的代理程序来说,这几秒钟的时间却显得非常漫长。这就产生了一个有趣的基础设施问题:如何获得全新环境的隔离效果,同时又不每次创建环境时都承担相应的成本?
代理式工作负载的随机性,以及代理需要快速启动的需求,正在考验甚至 Kubernetes 的灵活性。就像第一代 Kubernetes 不支持有状态的应用程序一样,社区仍在寻找最适合运行新一代代理式工作负载的抽象层
应对措施与方案
- 用于快速扩展基于 Kubernetes 的代理式工作负载的代理基础架构。通过这种架构,包含 AI 代理的 Kubernetes 容器在不需要时不会完全关闭,因为从休眠状态重新启动会引入过多的延迟,这会从用户的视角来看是不利的。相反,这些代理会保持在一个温热的池中,从而能够在毫秒级别被重新激活,而不是需要等待数秒才能完全从深度休眠中唤醒。
- 通过将人工智能工作负载限制在一个与其他 Kubernetes 工作负载逻辑上分离的沙盒中,企业可以更好地确保,如果某个人工智能工作负载超出了预期范围,那么由此产生的损害只会发生在该沙盒内。
9. KubeVirt 的下一个十年
KubeVirt 简介
KubeVirt 是由 Red Hat 在 2016 年创立的。其理念是让 Kubernetes 能够同时运行虚拟机和容器。
其他项目如 Open Sovereign AI Cloud(OSAC)也使用它来提供虚拟机、集群服务以及裸机服务。Cluster API Provider KubeVirt(CAPK)则使用 KubeVirt 虚拟机作为 Kubernetes 节点。Flight Control 项目在边缘环境中运行 virt-launcher,而无需完整的 KubeVirt 控制平面。
目前情况
目前,KubeVirt 已成为 CNCF 的孵化项目,有来自 Nvidia、Microsoft、AMD、Intel、SUSE 等公司的贡献者参与其中。社区正在努力使 KubeVirt 成为 CNCF 的正式项目。KubeVirt 改进提案流程正是在项目数量增加的情况下保持核心代码稳定的方式:先设计再编码,使用统一的跟踪系统,并由各个兴趣小组负责具体的改进工作。
未来的计划
设备、DRA 以及新硬件
在虚拟机上使用的 GPU 可以通过 Kubernetes 的动态资源分配功能进行申请,而无需使用专门的设备插件。这一功能在 v1.9 版本中处于测试阶段。目前,这种资源申请模式正在被扩展到通用主机设备、网络设备(如 SR-IOV)以及 CPU 上。不久的将来,虚拟机将能够同时申请 GPU、网络接口和 CPU,然后由 Kubernetes 来协调这些资源的分配。此外,还有相关工作旨在让 KubeVirt 能够根据虚拟机规格以及供应商的政策来生成这些资源申请对象,而无需用户手动创建资源申请对象。
一直的设计指导原则:优先采用与 Kubernetes 原生兼容的解决方案和机制,而非构建独立的虚拟化解决方案。
机密虚拟机器和可信的执行环境
用户越来越希望在共享的基础设施上运行敏感的应用程序和人工智能工作负载,同时能够在执行过程中保护他们的数据和模型。保密计算利用基于硬件的可靠执行环境来实现隔离,包括在平台的安全模型范围内对特权主机软件的防护。远程验证功能让工作负载所有者能够在信任该环境之前,先验证该环境的可靠性。KubeVirt 正在扩大对保密虚拟机的支持,并探索与验证服务和秘密释放服务的集成,其中包括来自 Confidential Containers 项目的 Trustee 服务。
在不增加核心组件的情况下扩展 KubeVirt
KubeVirt 是一个成熟的项目。其核心代码被严格保护起来。某个功能要被纳入 kubevirt/ kubevirt 的版本,需要很长时间,而且必须确保不会影响到现有的集群运行。这需要时间。有时候,社区成员可能认为某个功能根本就不应该被纳入核心代码。但这并不妨碍人们去开发这个功能。我们遵循了 Kubernetes 的可扩展性原则。用户应该能够编写出独立于核心功能的完整功能,同时仍能享受到 KubeVirt API 的保障。
结构化插件就是这样的实现方式。插件是一个以集群为单位管理的对象:包括领域钩子、节点钩子以及准入管理等功能。领域相关的变更可以使用 CEL 表达式来表达,而当钩子需要外部状态时,也可以使用侧载机制来处理。管理员可以查看并控制这些插件。这一功能在 v1.9 版本中仍处于测试阶段。
可更换的虚拟化堆栈
另一半则是虚拟化框架本身。libvirt、QEMU 和 KVM 在 KubeVirt 中扮演着核心角色。这些仍然是默认使用的组件,而这样的设置也是合理的。在 v1.8 版本中,我们增加了一种内置的 Hypervisor 抽象层,以及微软的 MSHV 后端作为可选功能。不过,我们的目标是让虚拟化框架具有可扩展性,这样用户就可以扩展 KubeVirt 的功能,让 Cloud Hypervisor、OpenVMM 或 Firecracker 等组件在外部环境中运行,而不会影响 KubeVirt 的运行。这项工作目前仍在进行中。
10. Kubernetes 控制平面中隐藏的故障路径
The hidden failure paths that affect Kubernetes control plane availability
背景
Kubernetes 的控制层旨在能够应对单独的故障,但其可用性仍然取决于关键路径中的组件在压力下的表现。在大规模部署的情况下,一个组件不必完全崩溃才会导致系统中断。一种有效的机制可以通过共享元数据、同步的启动过程,或者过于激进的健康检查来放大局部缺陷的影响。
例如,一个信息提供者可以向控制器提供集群状态的本地视图,这样控制器就可以在无需反复查询 API 服务器的情况下进行工作。当多个控制器独立启动时,这种方式非常高效。然而,当整个系统中有许多控制器同时重启时,重新构建这些视图就会给控制层带来巨大的压力。此时,信息提供者机制本身就变成了一种压力放大器。
案例简介
这篇文章探讨了三个案例。在第一个案例中,一个扩展 API 服务器在依赖项升级后发布了无效的架构,导致从未使用过该 API 的客户端无法访问服务。在第二个案例中,DaemonSet 代理程序在大量机器中重新启动,使得常规的启动过程变成了请求风暴,以至于 API 服务器难以处理这些请求。在第三个案例中,对 API 请求路径中某个组件的深度存活检查将依赖项的故障视为进程失败,导致组件反复重启,而该依赖项始终处于不可用状态。
总结与思考
每个案例都具有某种结构特性:一种机制可以在其自身的合同框架内正确运行,但同时仍可能违反其所属于系统的整体可用性契约。组件级别的正确性对于系统的可用性来说是必要的,但还不够。
总体设计原则是对每条在关键路径上的机制在假设被违反时的行为进行评估。模式聚合假设扩展会发布有效的模式。滚动重启策略假设 Pod 始终可用,但也可能突然不可用。活性检查机制认为重启会让进程更接近正常运行状态。当这些假设被打破时,这些机制可能会加剧原本旨在防止的故障。
对于那些大规模使用共享控制平面的平台团队来说,这些标准实际上是升级、恢复操作以及健康检查设计时的实用评估依据。
- 不仅要对扩展过程进行验证,还要确认客户端接收到的 schema artifacts 是否准确无误。
- 将信息收集的范围和启动操作限制在组件所需的最小资源集合内。
- 在组件在受损状态下仍能保持有效功能时,应将依赖项的监控与生死决策分开考虑。
- 测试在多个副本同时重启时的恢复行为。
这些做法有助于将局部故障控制在本地范围内,在依赖关系出现中断时保持必要的功能运行,同时避免常规的恢复工作变成严重的控制系统故障。
11. 在共享 Kubernetes 上沙箱化 AI Agent 的五个必要层次
The 5 essential layers of AI agent sandboxing on Kubernetes
背景
一个被赋予自主运行代码的人工智能智能体,必然会运行未经人类审核的代码。它可以安装模型选择的包,运行几分钟前生成的脚本,并不断迭代直到开发者的测试通过;这种风险仅限于笔记本电脑。对于公司来说,它可以超越代理的工作量,扩展到部署在共享Kubernetes基础设施上的任何工作负载。集群配置可以限制容器的系统调用,但允许调用达到内核漏洞时,仍可能暴露底层节点。
随着代理的激增,这一空白已将工作负载隔离从一个生态位加固需求转变为运行代理平台的基线需求。这是 Oracle Cloud Infrastructure(OCI)用户请求我们协助解决的一个挑战。
社区已经开发了解决方案。这些解决方案存在于五个层级:从 Pod 请求,向下到节点,再返回到代理会话。平台团队可以自行组装栈,而非重新发明,而原生服务商支持简化了配置和维护。托管的 Kubernetes 服务通过这种方式提供沙箱 Pod,但运行时对代理工作负载的隔离方式不同。
五个层次
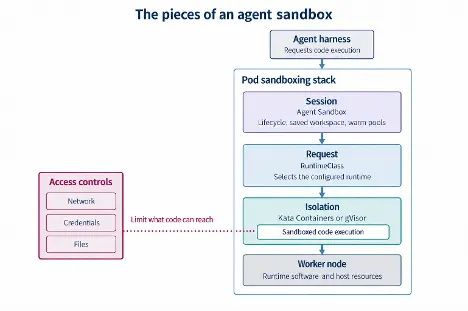
1. 隔离层:选择风险边界
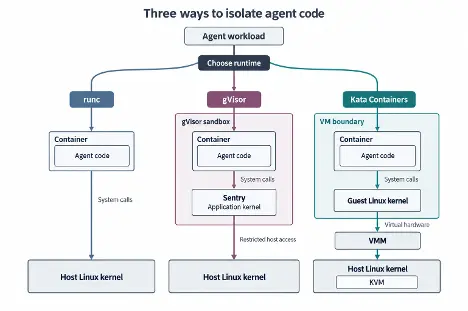
首先在最小隔离、受限内核接口和完整虚拟机隔离之间做出选择。每种选项都在安全性和性能之间存在权衡。
- RUNC 通过共享主机内核提供最佳性能。基于安全计算的过滤限制进程可调用的系统调用。
- gVisor 适用于仅限于受限内核接口的场景。其用户空间应用内核处理系统调用,而非启动客体 Linux 内核,因此工作负载通过一个小接口到达主机。
- Kata Containers 适用于需要完全虚拟机隔离的用例。每个 Pod 运行在带有自身访客内核的轻量级虚拟机中,代价是虚拟机启动和访客内核内存。
2. 节点:组装和计入节点
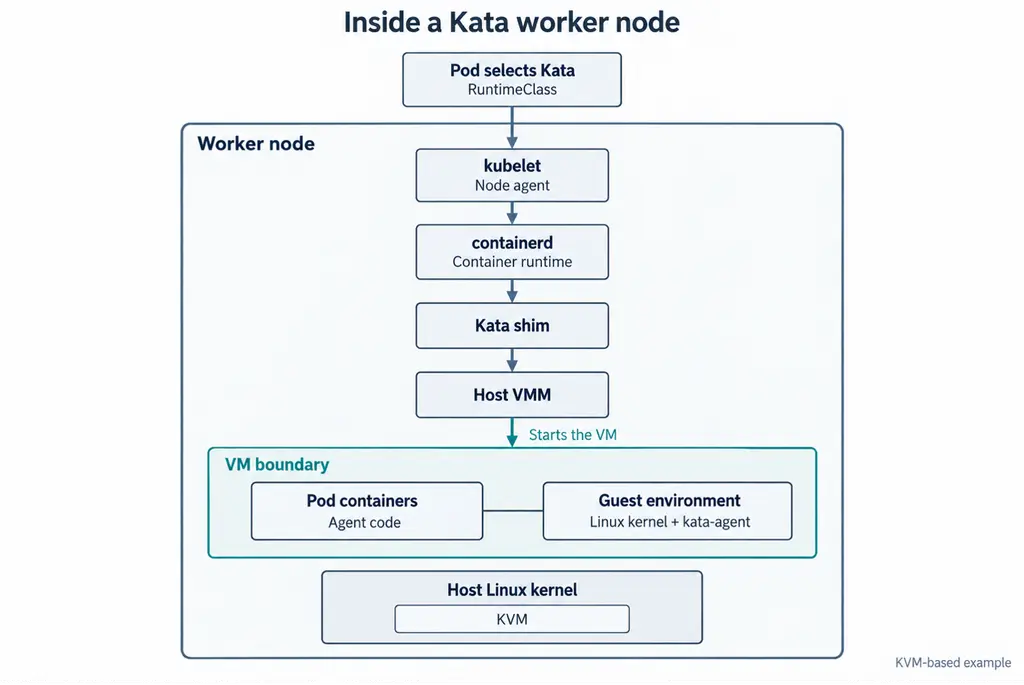
- runc 容器使用 Linux 命名空间来分离进程、文件系统和网络视图,并使用 cgroups 来控制资源使用。它们共享宿主内核。
- gVisor 在 Sentry 中处理工作负载系统调用,而一个独立的 Gofer 进程则中介对主机支持文件的访问。每个符合条件的节点都需要安装并集成 gVisor 运行时。
- Kata Containers 将每个 Pod 放入轻量级虚拟机中。工作负载系统调用会发送到客机 Linux 内核,并通过硬件支持的虚拟化与主机分离。这增加了开销,需要支持嵌套虚拟化的裸机节点或虚拟机。在基于内核的虚拟机(KVM)设置中,节点需要 Kata 运行时 shim、支持的虚拟机监控器(VMM)、KVM 和硬件虚拟化,以及包含 kata 代理的客体内核和镜像。
3. 访问层:限制代理的覆盖范围
沙盒策略与沙盒本身一样重要:
- 网络:默认以 NetworkPolicy 拒绝出口,然后只允许任务所需的目的地,如包镜像或模型端点。
- 凭证:发放针对任务的短效凭证,而不是挂载在舱内的长效令牌。泄露的凭证会随着任务一同失效。
- 存储:挂载仓库和数据只读,除非任务需要写入,并赋予可写工作区独立的卷。
- 远程工具:赋予 API 端点和 MCP 服务器自身授权。它们跑在沙盒外面,所以边界不覆盖它们。
4. 请求:RuntimeClass
Kubernetes 允许用户保留标准 Pod API,而选定的 Pod 包括代理则可选择进入更孤立的运行时。RuntimeClass 让 Pod 能够选择所需的安全和性能平衡,而无需对非代理工作负载产生负担。
额外的隔离会影响资源消耗和 pod readiness。gVisor 的 Sentry 进程和 Kata 的访客内核、kata-agent 和 VMM 增加了内存和 CPU 开销。在RuntimeClass中加上测量开销,使Kubernetes调度器和资源配额能够考虑这些开销。衡量你的工作负载,而不是复制示例。
5. 会话层:代理沙盒
Agent 的工作是断断续续的。代理运行代码后,等待数分钟或数小时与模型或人类的下一次交互。保持虚拟机运行可以让它随时恢复工作,但会占用容量。拆除它能节省容量,但之后需要重建。温水池提供了一个中间地带,但有备用容量。
由 Kubernetes SIG Apps 拥有的代理沙盒项目对这一选择进行了标准化。其沙盒 API 创建具备稳定身份和持久存储的有状态单一 Pod 环境,并支持模板、声明和温池扩展。它保持运行时无关性,并保持对所选 RuntimeClass 的隔离。
12. AI 工作负载正在重塑 Kubernetes 自动扩缩容:GPU 调度面临哪些新挑战?
AI 工作负载正在重塑 Kubernetes 自动扩缩容:GPU 调度面临哪些新挑战?
背景
长期以来,Kubernetes 通过两个几乎不需要相互沟通的控制循环之间的分工,默默承载着全球大量容器化软件:调度器把每个 Pod 放到已经存在的节点上;当 Pod 找不到可容纳它的节点时,自动扩缩容器负责添加节点。过去十年,这种分离是一种合理的设计,因为计算资源大体上可以相互替代,两个控制循环都不需要过多了解对方的决策,就能独立工作。
AI 工作负载及其运行所依赖的加速器改变了这些前提。这种清晰的分工仍然适用于大多数工作负载,而 AI 的快速发展,使得我们有必要重新审视它的边界。问题会以一种 GPU 运维人员都很熟悉的方式出现:一个本应能够调度的 Pod,偏偏就是无法调度,尽管集群实际上并没有耗尽容量。这种延迟可能让昂贵的加速器资源闲置。
人们的第一反应,往往是认为所在区域已经没有可用资源了。有时确实如此。但在另一些情况下,容量明明存在,Pod 却仍然处于 Pending 状态,因为自动扩缩容器愿意添加的节点,并不是调度器愿意使用的节点。
自动扩缩容器回答的是它最初被设计来回答的问题:是否需要添加节点。然而,真正的问题却是:这个节点的资源形态,究竟是否适合当前工作负载?
解决方案上的进展
容量预留:在工作负载到来之前承诺容量
拓扑:重要的不只是设备数量,还有设备之间的互连
共享:充分利用整个设备,而不是只用其中一小部分
接下来做什么
工作负载感知调度项目已表明,其范围计划随着时间推移,从调度器扩展到自动扩缩容领域。SIG-Autoscaling 社区的一份公开提案,也开始勾勒让两者直接沟通的集成 API。其中一个接口将让调度器看到能够被供应出来的容量,而不仅仅是已经存在的节点;另一个接口用于表达针对这些容量的放置偏好;还有一个接口则用于显式请求这些容量。
如果在设计一项功能时,就把自动扩缩容视为一等关注点,那么,在新的放置机制逐步成形的过程中,容量供应就会被纳入考虑,而不是等功能发布之后才去处理。这样,两个系统之间的边界,就会成为社区在设计之初主动权衡的问题,而不再是每次发布之后,自动扩缩容器都必须匆忙补齐的缺口。
值得保留的思维模型是:一个硬件模型,两个使用方。
📄 专题五 报告查看与分析
本月无。
💁♀️ 专题六 产品/方案介绍
1. OpenBao:管理、存储和分发敏感数据的软件解决方案
简介
OpenBao 是一款用于管理、存储和分发敏感数据的软件解决方案,包括机密、证书和密钥。OpenBao 社区计划以 OSI 批准的开源许可证提供该软件,由一个遵循开放治理原则的社区领导。
现代系统需要访问大量秘密:数据库凭证、外部服务的 API 密钥、面向服务架构通信的凭证等。了解谁访问了哪些秘密已经非常困难且平台特定。没有定制解决方案,几乎不可能添加密钥滚动、安全存储和详细审计日志。这正是 OpenBao 发挥作用的地方。
主要功能
- 安全密钥存储:任意密钥/值密钥可以存储在 OpenBao 中。OpenBao 在写入持久存储前会加密这些 Secret,因此仅仅获得原始存储的访问权限不足以访问你的 Secret。OpenBao 可以写入磁盘、PostgreSQL 等多种内容。
- 动态 Secret:OpenBao 可以为某些系统(如 AWS 或 SQL 数据库)按需生成 Secret。例如,当应用需要访问 S3 桶时,它会向 OpenBao 索取凭证,OpenBao 会按需生成具有有效权限的 AWS 密钥对。创建这些动态 Secret 后,OpenBao 也会在租约结束后自动撤销它们。
- 数据加密:OpenBao 可以对数据进行加密和解密,而无需存储数据。这使得安全团队能够定义加密参数,开发者也能将加密数据存储在如 SQL 数据库等位置,而无需自行设计加密方法。
- 租赁与续约:OpenBao 中的所有 Secret 都绑定了租赁合同。租约结束时,OpenBao 会自动撤销该 Secret。客户端可以通过内置的续租 API 续租。
- 撤销的支持。OpenBao 不仅可以撤回单个 Secret,还可以撤回一棵 Secret 树,例如特定用户读取的所有 Secret,或特定类型的所有 Secret。撤销不仅有助于钥匙滚动,还能在遭遇入侵时锁定系统。
拓展阅读
在 Kubernetes 上部署 OpenBao:用 CloudNativePG 构建无密码认证的 PostgreSQL 后端
🤔 专题七 有意思的事与 Meme
1. Kubernetes 上的 GPU 是“自带一切”,从账单开始
GPUs on Kubernetes are bring-your-own-everything, starting with the bill
从可观测性的角度,对于 CPU、内存的使用情况是可视的,但是对于 GPU 来说几乎都需要自行处理。一开始用的是 NVIDIA 的 DCGM 导出器,默认会在物理设备层面报告。当一个 Pod 单独拥有一块 GPU 时,这没问题,一旦你开始跨 POD 共享 GPU 时,DCGM 会给所有共享该 GPU 的 Pod 相同的值。所以如果三个 Pod 共用一个 GPU,看起来它们都在用整个 GPU,加起来就是 300%。通过时间切片或 MPS,驱动会为整个 GPU 暴露出一组计数器,因此 DCGM 没有每个 Pod 的数据,无法区分哪个工作负载消耗了什么。
GPU 是一个整数资源 nvidia.com/gpu: 1,请求和限制必须一致,调度器层面没有超卖。推理需要的分片共享发生在调度器之下,通过 time-slicing 或 MIG 完成,Kubernetes 的请求模型套不进去。所以“比较请求量和实际用量、回收差额”这套基础逻辑在 GPU 上几乎不存在,你得先搞清楚一个工作负载到底拿到了多少 GPU 容量,才能开始谈浪费。
GPU 每小时成本远高于 CPU,也更难按工作负载拆分。云厂商把 GPU 节点作为一行账单项,CPU、内存和 GPU 全部混在一起。要算出每个工作负载的真实金额,就得拆开这一行,并按型号给 GPU 部分加权,因为 T4 和 H200 价格完全不同,再分摊到共享该 GPU 的工作负载上。在 AWS 上,最便宜的支持 MIG 的 A100 约每小时 22 美元,Spot 约 14 美元,而同等规模的纯 CPU 实例约 5 美元,即使按 Spot 算差距也很大。
2. Kubernetes 是否真的对外部贡献者开放呢?
Contributing to Kubernetes without being in their "inner circle"
帖主提到近些年来,向 Kubernetes 的 GitHub 组织下的仓库提交了几个 Pull 请求。但这些请求都没有被任何人审查或合并。这些仓库中的 Pull 请求每天都会被多次合并。而提出这些请求并批准它们的人,大多是 Kubernetes 组织的成员们、在一家与 CNCF 相关的公司工作、CNCF 开发者计划的一部分。
回帖给出了一些可能的原因:
- 项目规模巨大,PR 过多
- 信任机制与不建议“微小修改”
可能的改进方式是加入具体的 SIG(兴趣小组)、相关会议与交流,以建立信任、获得相关的关注、了解组织架构。
2. 一些 PHP 官方维护者指责 Chainguard 违反协调披露协议,提前公开发布了修复镜像
PHP blames Chainguard for putting huge chunks of the web at risk
PHP blames supply chain security biz Chainguard for putting huge chunks of the web at risk
CVE-2026-109618 和 CVE-2026-109619 属于严重漏洞(这两个被称为 PHP2shell 的漏洞),未经身份验证的远程攻击者可利用它们在服务器上实现远程代码执行,从而完全控制受影响的服务器、窃取敏感数据或篡改网站。漏洞的影响版本十分广泛:影响过去十年发布的所有 PHP 版本,最早可追溯至 PHP 5.4。由于 PHP 支撑着全球约 70% 的公共网站,其潜在威胁面极其庞大。
周三,在为这两个漏洞发布紧急修复程序后不久,PHP 的维护人员发表了一篇博客文章,详细介绍了这些漏洞是如何被发现的以及如何被修复的:
- 周二:网上开始流传漏洞 CVE ID 及错误信息,PHP 维护者决定将原定于周四的披露时间提前至周三。随后,Calif 不小心发布了 PoC 演示视频。
- 周三上午:在官方预定发布时间的 6 小时前,Chainguard 提前公开发布了已包含修复补丁的镜像。
Chainguard CEO Dan Lorenc 表示他们并没有主动泄露技术细节,提前发布补丁是因为当时野生攻击和 PoC 已经开始传播(情况已失控)。他们根据“野外已有活跃利用”的例外条款做出了提早发布的决定,并指出其蜜罐系统已捕捉到来自中国和俄罗斯 IP 的扫描与攻击。
🎤 漏洞发现得快,解决得也快。我们未来是否会生活在一个完美无瑕的纯净世界。