
🆕 专题一 产品新功能/新版本
1. OpenShift 集成 NVIDIA 的 BlueField 安全和加速技术
BlueField 是 NVIDIA 推出的一种数据中心基础设施处理单元(DPU)平台,专为加速、卸载和隔离现代数据中心及 AI 工厂中的网络、存储与安全任务而设计。
NVIDIA DOCA(全称 Data-Center-Infrastructure-On-A-Chip Architecture,片上数据中心架构)是英伟达专为 NVIDIA BlueField DPU(数据处理单元)和 SuperNIC 打造的统一软件开发框架与生态平台。它可以被看作是服务器和数据中心基础设施领域的 CUDA——正如 CUDA 释放了 GPU 的并行计算潜力一样,DOCA 旨在释放 DPU 的全部硬件潜能。
将 NVIDIA BlueField 集成到 OpenShift 中,能够解决多种环境中的关键基础设施问题。对于电信服务提供商来说,要满足严格的服务级别协议要求,就需要具备确定的延迟性能和高吞吐量数据包处理能力。将 Open vSwitch 和 OVN-Kubernetes 相关的处理任务直接卸载到 BlueField 芯片上,可以在不消耗主机 CPU 资源或不进行昂贵的交换机结构重新配置的情况下实现高速网络传输。对于受电源和空间限制的边缘站点而言,将基础设施处理任务卸载到 BlueField 上可以最大化计算密度,降低站点运营成本,并确保在硬件层面实现租户隔离。
将 NVIDIA BlueField 集成到服务提供商 Red Hat OpenShift 环境中,可以带来三个重要的架构优势:
- 基础设施服务的解耦:将 OVN-Kubernetes 网络堆栈的处理任务转移到了 BlueField 的硅回收技术上,从而将原始的计算能力重新分配给实际应用工作负载。
- 安全性与隔离性:将基础设施控制平面运行在 DPU 上,可以使其与租户的工作负载域完全分离。即使租户的应用程序受到攻击,底层网络控制平面仍然保持安全且不受干扰。
- 性能提升:专为高性能需求设计的硬件加速处理技术,能够实现确定性的网络性能,并具备高达 400 Gb/s 的高速传输能力,从而绕过主机软件的瓶颈问题。
📰 专题二 新闻与访谈
1. Karmada 正式毕业:多集群 Kubernetes 编排迈入生产级成熟新阶段
Karmada 正式毕业:多集群 Kubernetes 编排迈入生产级成熟新阶段
从 2020 到毕业:Karmada 的 CNCF 进阶路径
- 2020 年 11 月:首次代码提交
- 2021 年 9 月:以 Sandbox(沙箱)项目身份加入 CNCF
- 2023 年 12 月:晋升 Incubating(孵化)阶段
- 2026 年 9 月:正式毕业
下一步:从“跨集群分发”走向“资源感知型控制平面”
Karmada 的 2026 路线图将继续推动多集群 Kubernetes 从基础工作负载分发,向更具资源感知能力的控制平面演进。重点方向包括:基于优先级的抢占、多集群 AI 训练与批处理任务队列,以及面向 GPU 和其他加速器的 Kubernetes Dynamic Resource Allocation(DRA)多集群支持。
2. Red Hat 准备推出 MCP 服务器,以帮助大型语言模型更好地管理 Kubernetes 集群
Red Hat Readies an MCP Server to Help LLMs Manage Kubernetes
Red Hat 正在开发一个开源的 MCP 服务器扩展,旨在帮助开发人员和管理员更好地管理 Kubernetes 以及 Red Hat 自己的 OpenShift Kubernetes 发行版。该扩展可以帮助 Visual Studio Code、Microsoft Copilot 和 Cursor 等 AI 助手来控制和与 Kubernetes 集群进行交互。它是目前众多开源 MCP 服务器之一。不过,Red Hat 的解决方案具有出色的设计:它提供了完整的 API 访问功能,而且只需安装一个二进制文件即可使用。Red Hat 的 MCP 服务器是用 Go 编程语言编写的。它作为一个独立的二进制文件运行,无需任何外部依赖。该服务器既可以用户在本地机器上运行,也可以在集群环境中运行。用户可以通过 Streamable HTTP 或 Server-Side Events(SSE)来访问该服务器。
例如,MCP 可以作为一种渠道,让集群管理员能够用自然语言来询问与集群相关的问题。比如:“请显示过去 24 小时内所有处于 CrashLoopBackOff 状态的 Pod 信息”,或者“为什么我的部署无法正常扩展?”
在为 Kubernetes 实现 MCP 服务器方面,Red Hat 并非唯一的选择。Stacklok 提供了基于 Go 语言的实现方案,名为 mkp,用于处理 Kubernetes 的核心资源操作。MCP K8S Go 则是另一个基于 Go 语言的开源实现方案。
在其他方面,mcp-kubernetes-server 项目是基于 Python 开发的。该项目提供了自然语言接口,便于用户与 kubectl 命令以及 Python Kubernetes SDK 进行交互。开发者 Alexei Ledenev 将他的 MCP 服务器封装在 Docker 容器中,同时还包含了多个用于操作 kubectl、helm、istioctl 和 argocd 的云原生工具库。
3. Broadcom 将 AI 就绪的数据基础设施、Agent 运行环境、安全控制和观测能力整合进 Tanzu 平台
背景
企业 Agent 在获得自主执行权限后,可能造成:
- 敏感数据泄露或越权访问
- Token 消耗失控
- 产生错误或虚假的结果
- 无法追踪 Agent 使用了哪些数据、工具及凭证
- 企业为了接入 Agent,被迫迁移或重建现有数据架构
Broadcom 的思路是:不要求企业把数据迁移到新的数据湖仓,而是在数据原有位置进行解析、清洗、向量化和语义标注,再以受控方式提供给 Agent。
相关能力
- AI 就绪的数据基础设施:Tanzu 可以处理结构化、非结构化以及多模态数据,并通过语义层为 Agent 补充上下文。数据可以继续保留在企业私有云或防火墙内部。
- 默认拒绝的 Agent 沙箱:Agent 默认不能访问网络、API 或其他资源,只有获得明确授权后才能连接。
- 内置 Agent 开发框架
- 统一目录和框架支持
- 可观测性与审计
4. Cloud Native Community China 正式成立
连接全球生态,深耕本土实践——Cloud Native Community China 正式成立
CNCC 是云原生基金会(CNCF)“开放社区小组”(Open Community Group, OCG) 计划的核心成员。该计划旨在通过提供标准化的运作框架与丰富的全球资源,支持区域性技术社区的独立发展与高效协作。CNCC是CNCF在中国官方支持与深度协作的区域性官方技术社区。依托 OCG “开放、平等、包容”的开源理念,CNCC 将精准聚焦中国开发者的真实诉求,通过本土化运营,打破沟通壁垒,加速AI时代的技术迭代。
官网:https://ocgroups.dev/cncf/group/cncf-china
🔐 专题三 安全
💬 专题四 讨论与分享
1. Kubernetes 1.37 相关新功能介绍
拓展阅读:Kubernetes 1.37: Deep dive into new alpha features
成为 GA 功能
metrics.k8s.io API
Kubernetes v1.37: Metrics API graduates to stable
Kubernetes v1.37 将 metrics.k8s.io API 升级为稳定版本( v1 )。该 API 用于获取节点和 Pod 的 CPU 及内存使用情况。它是诸如 kubectl top 这类命令以及基于资源指标的自动扩缩容功能所依赖的 API。
该 API 提供了两种类型的资源:
NodeMetrics :表示某个节点的 CPU 和内存使用情况。
PodMetrics, for CPU and memory usage for a Pod, with a per-container breakdown in its containers field.
PodMetrics :表示某个 Pod 的 CPU 和内存使用情况,其中 containers 字段则详细列出了每个容器各自的 CPU 和内存使用情况。
这一升级意味着该 API 现在具备了与 Kubernetes 稳定 API 相同的稳定性保障。v1 API 的接口与 v1beta1 完全相同,唯一的区别在于 API 的版本号。没有字段被重命名,也没有新增字段。此外,返回的 CPU 和内存数值的含义也没有任何变化。
kubectl top 同时支持这两种 API 版本。在条件允许的情况下,它会优先使用 v1 ;而对于那些尚未支持 v1 的集群,则会自动切换到 v1beta1 。目前,HPA 控制器仅支持 v1beta1 。虽然计划在 Kubernetes v1.37 之后添加基于发现机制来选择 v1 或 v1beta1 的功能,但在当前版本中该功能尚未实现。
您无需启用任何功能开关。Metrics API 是通过 API 聚合层来提供的,具体实现可由 metrics-server 等工具来完成。您可以选择任何 metrics.k8s.io 的实现方式;为了让 v1 Metrics API 能在您的集群中正常使用,您所选择的实现方式必须能够提供 v1.metrics.k8s.io API,同时还需要注册相应的 APIService。
目前,v1beta1 仍然可用,且 HPA 控制器仅支持 v1beta1 。
Pod 证书与集群信任包
Kubernetes v1.37: Pod Certificates and Cluster Trust Bundles
到目前为止,Kubernetes 内置的主要身份验证机制就是服务账户 JWTs(JSON Web Tokens)。这些经过加密处理的令牌由集群的控制平面颁发,它们能够确保全世界的人都能明白:当你的工作负载使用这些令牌进行通信时,究竟是谁在发起请求。不过,服务账户的 JWT 有一个很大的缺点:它们属于“持有者令牌”。使用持有者令牌时,只要拥有该令牌,那么该令牌所代表的身份就归你所有。由于你必须将 JWT 的副本提供给所有需要与之进行身份验证的对方,因此,那些持有 JWT 副本的人也可以冒充你的身份。
解决这个问题的办法在于使用“拥有权证明”机制。在这种机制中,你不需要将完整的凭证发送给对方,只需提供自己确实拥有该凭证的证明即可。实际上,这类方案都是基于非对称加密技术来实现的(比如 RSA、ECDSA 等)。
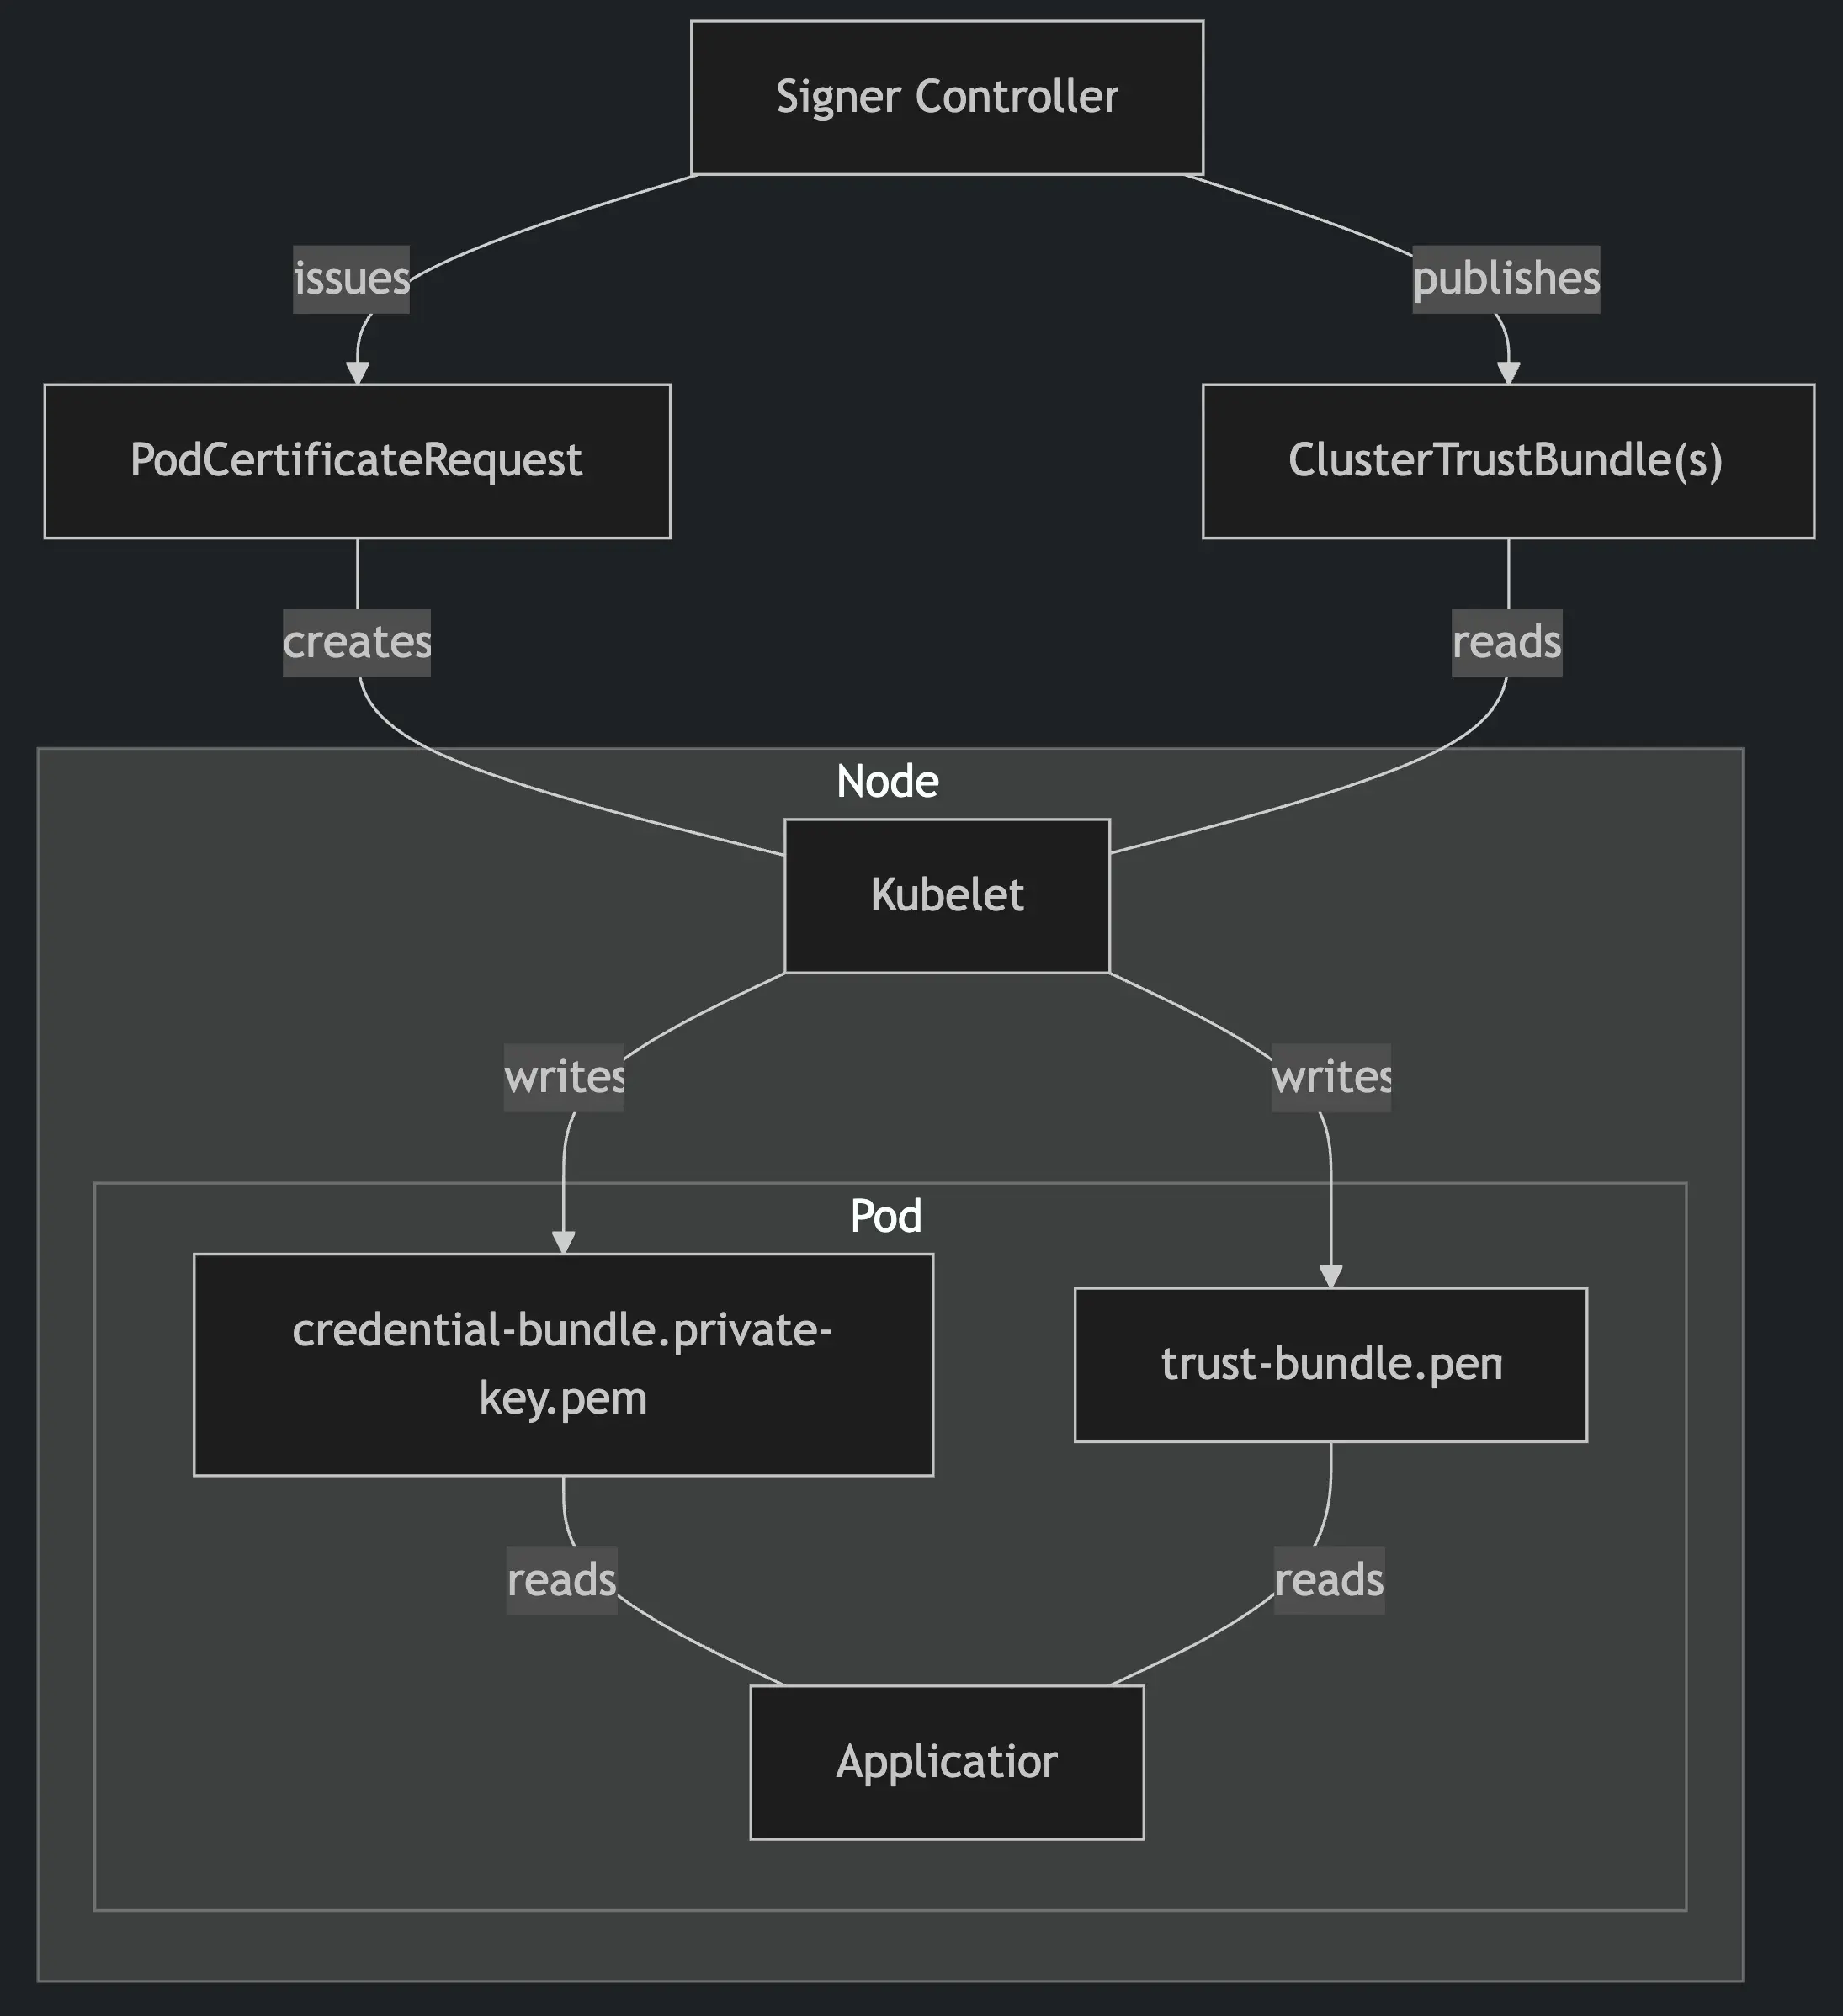
在 Kubernetes 1.37 版本中,一种全新的内置生产级身份验证技术正式投入了实际应用。Pod 证书(以及与之相关的 Cluster Trust Bundles)将用于 TLS 和 mTLS 协议的 X.509 证书颁发功能直接整合到了 Kubernetes 的核心系统中。Pod 证书的目的是让用户在 Kubernetes 环境中使用 X.509 证书变得与使用服务账户的 JWT 令牌一样简单,同时又能保持 Kubernetes 的高安全性。
架构如下:
默认情况下已启用存储版本迁移功能
Kubernetes v1.37: Storage Version Migration Enabled by Default
Kubernetes 资源通常以某个 API 版本的内部格式存储。即使将 CRD 的默认存储版本从 v1alpha1 更新为 v1,已有对象仍可能保留在旧版本中。
在某些情况下,你可能需要更改资源的存储版本。例如,当你想要升级 CRD 时,就需要将较旧的 API 版本(如 v1alpha1 )替换为较新的版本(只保留 v1beta1 和 v1 )。不过,如果在仍有资源使用着旧版本的 API 时才尝试删除旧版本,就会引发问题。
启动存储版本迁移的操作非常简单,只需创建一个声明式的 StorageVersionMigration 对象即可。Kubernetes 控制平面中的内置 StorageVersionMigrator 控制器会持续监控这些对象,并自动将现有资源迁移到该 API 对应的默认存储版本上。
在迁移过程中,StorageVersionMigrator 控制器会不断更新 StorageVersionMigration 对象的 status 字段。您可以使用 kubectl 来查看迁移的进度情况。
一旦迁移成功,您可以确信,该资源在所有存储位置上的副本都保存在了当前的存储版本中。对于 CRD 而言,其存储版本应在 CRD 的 .status.storedVersions 字段中得到更新,以确保其中仅包含所需的版本信息。如果迁移成功后 .status.storedVersions 字段没有得到更新,那就意味着该 CRD 在迁移过程中已被更新了。在这种情况下,需要重新尝试迁移操作,才能确保旧版本的存储方式被正确地废弃。
DRA 相关改进已进入稳定阶段
- DRA 的扩展资源支持功能:该机制使得 DRA 驱动程序能够处理通过传统扩展资源 API 发出的请求——比如在 Pod 配置文件中使用的 example.com/gpu 。这样一来,就不需要在 DRA 驱动程序之外再安装额外的设备插件。扩展资源的名称可以直接在 DeviceClass 上设置,需要使用该扩展资源的 Pod 会通过 DRA 与相应的设备进行匹配,而无需在工作负载端进行任何额外的配置。
- 通过添加标准的网络接口相关数据,ResourceClaims 的状态信息得到了进一步完善。在 ResourceClaim 中新增了 devices 字段,这使得 DRA 驱动程序能够报告每台设备的状态信息。对于网络设备而言,这些信息还包括接口名称、MAC 地址和 IP 地址。这样一来,用户和控制器就能了解设备的状态了——而在之前,一旦设备被配置到某个 Pod 中,其状态就无法被知晓了。这一改进使得基于设备所报告的 IP 地址来构建网络服务成为可能。
- DRA:设备污染与容忍机制现已稳定。DRA 驱动程序可以将某些设备标记为“受污染设备”,从而在新的 Pod 调度过程中跳过这些设备。集群管理员还可以通过 DeviceTaintRule 在整个集群范围内应用相同的污染标记,而无需重新配置驱动程序。那些使用了受污染设备的 Pod 可以被自动移除,除非该 Pod 的 ResourceClaim 明确允许该设备被使用。这一机制与节点的污染与容忍机制类似,使得操作员能够将某个设备暂时离线进行维护,或将其标记为“状态不佳的设备”,而不会影响集群的其余部分。
- numaNode 设备的标准属性将 resource.kubernetes.io/numaNode 统一为共享的属性名称。这样一来,来自不同驱动程序的设备就可以在同一个 NUMA 节点上进行比较,而无需每个驱动程序都自行定义该属性的名称。这一功能在 1.37 版本中直接被正式采用,因为它属于命名/注册相关的功能,不会对系统的其他功能造成任何影响。
KubeletInUserNamespace 模式(即“无根模式”)
Kubernetes v1.37: KubeletInUserNamespace (aka Rootless mode) Graduates to Beta
启用该功能后,所有的节点组件(kubelet、CRI 和 OCI 运行时、CNI 插件以及 kube-proxy)都可以在主机上以非根用户身份运行,从而利用 Linux 的用户命名空间来管理这些组件。这种模式也被称为“无根模式”。
这一功能不应与用于容器的用户命名空间相混淆(即 hostUsers: false 功能与 UserNamespacesSupport 功能门控机制的结合,该功能自 1.36 版本起正式启用)。用户命名空间将容器置于相应的用户空间中,但节点上的组件仍以 root 身份运行。这两种功能并不冲突。此外,它们还可以结合使用,从而在 Kubernetes 内部再创建一个 Kubernetes 环境,而无需完全启用 privileged: true 功能。
通过在用户命名空间中运行各个节点组件,潜在的损害会被限制在非根用户的账户范围内。值得注意的是,攻击者无法通过修改内核、引导加载程序或固件来掩盖自己的入侵行为。
成为 Beta 功能
HorizontalPodAutoscaler 支持将工作负载的副本数调整为 0
Kubernetes v1.37: Scale Workloads to Zero with HorizontalPodAutoscaler
Kubernetes v1.37 新增了对工作负载水平自动扩缩容的支持,甚至可以将副本数降至零。该功能目前处于测试阶段,但默认处于启用状态。通过使用合适的对象指标或外部指标,HorizontalPodAutoscaler(HPA)可以将工作负载的副本数降至零,然后在指标发生变化时再恢复到正常数值。
将规模缩小到零后,那些处于空闲状态的 Pod 将从诸如队列消费者和批处理处理器之类的工作负载中移除。当每个 Pod 都占用着宝贵的资源时,这种优化带来的效益最为显著,这些宝贵资源包括专用 CPU 或 GPU。
其代价就是应用程序的启动时间:HPA 需要先监测相关指标、安排 Pod 的启动时间,然后再启动应用程序。当任务可以暂时等待在队列中时,这种机制就能正常发挥作用。当没有可用的 Pod 时,Kubernetes 服务不会缓存请求。因此,对于那些依赖 HTTP 请求来运行的工作负载来说,就需要有独立的缓存层来处理这些请求。
如果手动将 Deployment 数量设置为零,自动扩缩容功能将会被暂停。HPA 也保留了这一行为:它不会去唤醒那些并非由自己主动缩减规模的工作负载。
etcd 的 RangeStream 功能有助于减少在处理大型数据列表时的内存消耗
Kubernetes v1.37: etcd RangeStream Cuts Memory Use on Large List Reads
API 服务器主要通过内存中的缓存来处理各种列表和监控相关的请求。要填充该缓存,需要在启动时以及每次重新初始化时,从 etcd 中读取该资源的完整信息。对于那些包含大量对象的资源,比如 Pod,这样的读取操作会非常耗费资源。
API 服务器已经采用了分页机制来处理数据读取请求:它每次向 etcd 请求的键的数量是固定的,而不是一次性请求全部数据。不过,由于分页是根据键的数量来划分的,而并不考虑每个对象的大小,因此,如果某一页包含大量数据,那么该页面所占用的内存也会非常大。这就使得内存使用情况难以预测。当对象大小与并发读取请求的数量相互冲突时,就有可能导致内存溢出。etcd 在发送每个页面之前会先将其完整地组装起来,而 API 服务器在解码数据时也会暂时保存该页面的内容。这样一来,相同的数据在 etcd 和 API 服务器的内存中都会被存储一次。大部分处理成本都由 etcd 承担,而流式处理方式则有助于减轻这一负担。
etcd v3.7 新增了这种读取方式的流式处理版本,即 RangeStream RPC。该机制使用与 Range 相同的输入参数,也会返回相同的结果集。不过,etcd 不会一次性将所有数据全部返回,而是将数据分割成多个块并逐个传输。块的大小会根据返回数据的大小动态调整。这样一来,当处理大量数据时,内存消耗就不再受键的数量限制,而是受数据总量的限制。此外,随着数据流的传输,内存也会被及时释放,而不必等到整个数据页都处理完毕才释放内存。
当该功能被启用后,API 服务器在从 etcd 中读取整个数据集时,都会使用 RangeStream 作为标识。这包括数据缓存的初始化过程,以及那些无法从缓存中获取数据而必须直接从 etcd 中读取数据的场景。无论哪种情况,API 服务器都会在接收到每个数据块后立即对其进行解码,然后再获取下一个数据块。这样一来,任何一方都不会同时持有整个数据集。
启用该功能需要 Kubernetes 1.37 及以上版本、etcd 3.7 及以上版本。
DRA 相关改进已进入 beta 阶段
- 在 DRAWorkloadResourceClaims 功能开关处于关闭状态时,Workloads 对 ResourceClaim 的支持已进入测试阶段。在启用了该功能的集群中,Workloads 和 PodGroups 可以直接使用 ResourceClaim。这样一来,一个 ResourceClaim 就可以被整个 Pod 组共享。而按照旧的按 Pod 分配的限制,每个 ResourceClaim 最多只能被 256 个 Pod 使用。
- DRA 设备属性向下接口旨在支持将设备插入到 KubeVirt 虚拟机中。在准备相关声明时,驱动程序会填充 Metadata 字段。该框架会将这些信息写入通过 CDI 挂载到容器中的 JSON 文件中。这样一来,工作负载可以直接读取设备的 PCI 总线地址、MAC 地址以及其他属性,而无需再依赖自定义控制器来处理和转换各种资源声明和资源切片信息。
进一步提升对工作负载的智能调度能力
Kubernetes v1.37: Advancing Workload-Aware Scheduling
为满足现代高性能分布式工作负载的层次化调度需求,v1.37 版本引入了新的 CompositePodGroup API。该 API 有助于处理复杂、异构的 Pod 组所涉及的各级拓扑结构约束、批量调度机制以及抢占策略。更重要的是,这一架构上的改进使得系统能够原生支持那些通常由 JobSet、LeaderWorkerSet(LWS)等高级扩展 API 来管理的复杂工作负载结构。
除了这些 API 的新增功能外,v1.37 还致力于简化各组件的集成过程。为此,该版本引入了一组新的控制器集成 API 以及 workloadbuilder Go 语言库。这些工具提供了标准化的接口,大大简化了外部控制器与 WAS 系统的集成过程。借助这些新工具,原生 Job 控制器的集成功能得到了升级:现在,它能够充分利用 WAS 系统的各项 API 功能,从而实现更复杂的调度策略、更灵活的故障处理机制,以及针对标准批处理任务的智能调度功能。
例如,PodGroup 现在作为调度队列中的一等对象处理,同一组 Pod 不再分别排队,有助于保证它们具有一致的调度行为。调度器现在能够理解 PodGroup 的中断策略,这避免了“工作负载声明必须整体中断,但普通 Pod 抢占逻辑仍然只驱逐其中一个 Pod”的不一致行为。CompositePodGroup 允许构建多级工作负载层级。调度器会递归评估整棵层级树,并将整个层级视为一个调度单元。只有满足根组和所有子组的约束后,相关 Pod 才会整体绑定,从而避免产生无法运行的部分部署。
原生直方图功能
Kubernetes v1.37: Native Histograms Graduates to Beta
在 Kubernetes 的可观测性功能刚刚被引入之初,用于衡量各种指标的持续时间与延迟值(比如 API 服务器的请求延迟或调度所需的时长)的数据,都是通过 Prometheus 的直方图来呈现的。传统的直方图分析方法要求数据制作者预先确定一系列固定的累积区间边界值(即 le 标签),比如 0.005, 0.01, 0.025, 0.05, 0.1, 0.25, 0.5, 1, 2.5, 5, 10 。虽然这种做法很常见,但它存在三个主要问题:
- “桶状划分猜测游戏”:如果某个工作负载的延迟情况发生变化,比如延迟时间降至微秒级别,或者出现超出最高阈值的长尾延迟,那么直方图就不再具有参考价值了。要想提前确定桶的划分范围,就必须先了解数据的分布情况。
- 高基数与存储成本:在传统的直方图表示方式中,每个区间边界都被视为一个独立的时间序列数据点。如果一个直方图包含 10 个区间,且这些区间分布在多个标签上,那么时间序列的数量就会增加 10 倍。这会增加 Prometheus 的内存消耗,同时也会提升时间序列数据库的存储成本。
- 分位数的插值误差:使用 histogram_quantile() 来计算百分位数时,需要依据各个固定区间之间的线性插值来进行计算。如果这些区间的跨度较大,那么分位数的计算结果可能会出现较大的误差。
Prometheus 原生直方图用动态的、指数型的区间来替代了静态的用户定义区间。与其为每个时间区间都生成单独的时间序列,不如将整个直方图作为一个整体来存储。这个时间序列包含了各种详细信息:正数和负数的跨度、零值阈值以及指数缩放因子等。
- 高分辨率自动调整:指数型时间桶能够动态适应各种时间范围——从纳秒到小时不等——无需预先设定时间桶的边界。
- 时间序列数量最多可减少 90%:通过将各个时间段合并为单个时间序列中的结构化数据,大大降低了数据采集和存储的复杂度/成本。
- 精确的分位数计算:无论观测值如何,都可以通过数学方法来精确计算分位数,其误差范围相当有限(在默认设置下,最坏情况下的相对误差约为 5%)。
内存 QoS
Kubernetes v1.37: Memory QoS Graduates to Beta
在 Kubernetes v1.37 版本中,内存服务质量控制功能已进入测试阶段,现在默认处于启用状态。在运行 cgroup v2 的 Linux 节点上,该功能会利用内存控制器来为内核提供更准确的指导,帮助内核更好地管理容器内存。该功能最初在 v1.22 版本中以“Alpha”阶段的形式被引入,而在 v1.36 版本中则进一步得到了完善,增加了分层内存预留功能。
Pod 级资源管理功能
Kubernetes v1.37: Pod-Level Resource Managers graduated to Beta
在这一功能出现之前,为了满足那些对延迟要求极高的应用程序的需求,集群管理员不得不做出非此即彼的选择:要么为 Pod 中的每个容器分配相应的资源,要么完全放弃使用具有 NUMA 对齐特性的 CPU 核心和内存。对于那些运行着轻量级辅助进程的现代工作负载来说(比如日志记录工具或遥测数据发送程序),为这些辅助容器分配专用物理核心是一种浪费。
Pod 级资源管理器通过支持混合分配模式来克服这一难题。Kubelet 可以为主要的应用程序容器预留专用的、符合 NUMA 架构的资源;而那些不需要高可靠性的辅助进程则可以被放入一个与 Pod 隔离的共享资源池中。这样一来,主要工作负载就能享受不受限制的、符合 NUMA 架构的性能表现;而辅助进程则可以受益于与 Pod 隔离的共享资源池,从而享受 NUMA 架构带来的性能优势,同时避免受到外部节点的干扰。整个过程无需占用专门的物理核心资源。
Kubernetes 的块更改跟踪 API 已更新
Kubernetes Changed Block Tracking API - Beta Differences
该版本的主要变化在于:SnapshotMetadataService CRD 的版本从 v1alpha1 升级到了 v1beta1 。原本用于发布驱动程序元数据信息的 CRD,现在则用于提供 cbt.storage.k8s.io/v1beta1 相关服务。虽然其架构本身没有变化,但此版本不再包含 v1alpha1 相关内容(即不再与新版本一起提供该功能)。如果您是从 Alpha 版本升级而来的,那么需要执行相关操作。
Changed Block Tracking (CBT) 是一项用于提升容器持久化存储备份效率的块级变更追踪技术。CBT 允许备份工具查询两个不同持久卷快照(PersistentVolume Snapshot)之间发生修改的数据块。它只传输和备份发生变化的数据块,而不必扫描整个存储卷或传输冗余数据,从而大幅缩短备份窗口并降低网络与存储开销。主要基于容器存储接口(CSI)。
跟踪 PersistentVolumeClaim 的最后使用时间
Kubernetes v1.37: Tracking When a PersistentVolumeClaim Was Last Used (Beta)
在大型 Kubernetes 集群中,用户通常会创建 PVC,然后在删除相关 Pod 时并不清理相应的存储空间。因为 Kubernetes 不会在 Pod 被删除时自动删除对应的 PVC(这是为了防止数据丢失)。随着时间的推移,这些被遗弃的 PVC 会越来越多,从而占用更多的存储空间,增加云服务成本。
通过该功能,PersistentVolumeClaim(PVC)保护控制器会为每个 PVC 添加一个 Unused 条件,从而告知用户是否有正在运行的 Pod 引用了该 PVC——无需任何额外的工具或复杂的交叉引用操作。
成为 Alpha 功能
DRA 相关改进已进入 Alpha 阶段
- 一个设备属性可以包含多个值,而不再只是单一的数值。例如,某个 CPU 可能连接着多个 PCIe 总线。这样一来,就可以根据设备所具有的值的组合来区分不同的设备了。当然,那些只包含单一值的属性则依然按照原来的方式来使用。
- 节点可分配资源请求的功能已纳入 Alpha 2 版本中。该功能使得调度器和 Kubelet 能够以与处理普通资源请求相同的方式来处理由 DRA 管理的 CPU、内存等节点资源。这样一来,节点就不会出现资源过度分配的情况,用户也不必再在 ResourceClaim 和 Pod 配置文件中重复提交相同的资源请求了。
- 在 Kubernetes 1.37 版本中,资源可用性的查询功能进入了第二个测试阶段。用户需要创建一个 ResourcePoolStatusRequest 来获取某一时刻的资源可用性信息。若想刷新该信息,需删除原有的请求后再重新创建。需要注意的是,这并非一种用于持续监控的资源查询 API。
- 可选的节点操作功能允许驱动程序跳过那些在节点上无需任何准备的资源分配操作。这样一来,就可以避免在那些实际上不需要驱动程序进行任何操作的场景下,仍然让驱动程序承担不必要的任务。
- “派生属性”是一项新功能,它允许你使用 CEL 表达式,根据自己定制的规则来匹配不同的设备。
- DRA 设备兼容性组功能允许驱动程序为设备的各个分区指定兼容性组标签。例如,同一块 GPU 上可以同时使用 MIG 和 vGPU 模式,但必须确保它们属于不同的兼容性组。这样一来,调度器就能在事先拒绝那些不兼容的组合,从而避免在节点准备阶段出现驱动程序故障。该功能由 DRADeviceCompatibilityGroups 特性开关控制,默认处于禁用状态。
- PreQueueingHint 扩展点是在 1.37 版本中作为 Alpha 测试功能首次引入的。在旧版本中,DRA ResourceClaim 事件会触发对所有无法调度的 Pod 的全面扫描。在大规模部署的情况下,这种处理方式会导致 O(N²)级别的计算成本。现在,DRA 插件利用了 Pod Informer 索引来仅处理那些真正受影响的 Pod,从而将处理时间缩短到 O(1)。在初步测试中,这一改进使得调度效率提升了近一倍。该功能的启用与否由 SchedulerPreQueueingHints 特性开关来控制。
- DRA 的消耗能力现在支持在 CapacityRequestPolicyRange 中使用小数值。这样一来,那些拥有有限资源的设备就能更精确地请求和分配资源。这一改进提升了那些需要精细资源分配的工作负载的灵活性。该功能受 DRAFractionalCapacityRange 功能门的控制,该功能在 1.37 版本中处于测试阶段。
节点生命周期 conditions
Kubernetes v1.37: Introducing Node Lifecycle Conditions
Kubernetes 有多种方式来描述节点上发生的事情。准备度、污染点、Pod 状态、标签、注释和提供者专用 API 都暴露了画面的一部分。一直缺少一个共享的、Kubernetes 拥有的方式来表示节点正在耗电、维护或正在优雅节点关闭。Kubernetes v1.37 引入了五个 condition,提供了该描述:
- DrainInProgress:该节点正在根据管理员选择的排空标准主动排空。
- Drained:该节点已达到管理员选择的排空标准。
- MaintenancePlanned:预计该节点未来会发生变更。
- MaintenanceInProgress:该节点正在进行维护。
- GracefulNodeShutdownInProgress:判断该节点正在进行优雅节点关机。
每个生命周期 condition 使用 status 来报告观测值是否处于激活状态:True、False、Unknown。
对正在运行的 Pod 进行大小调整的调度器预占机制
Kubernetes v1.37: Scheduler Preemption for In-Place Pod Resize (Alpha)
在 Kubernetes 中,资源的分配方式过去都是静态的,即在 Pod 初次调度和部署时确定下来。随着 v1.35 版本的发布,核心的“Pod 大小调整”功能终于实现了全面可用。这样一来,应用程序开发人员和集群管理员就能够动态地调整正在运行的容器的 CPU 和内存分配情况,而无需导致系统重启或应用程序中断。不过,就地调整大小的做法会引发一种特殊的资源调度问题:如果某个正在运行的 Pod 请求的资源增加量超出了主机节点所能提供的资源限度,Kubelet 就不得不将此请求标记为“ Deferred ”状态。该 Pod 将一直处于这种状态,等待节点上的资源空出来之后才能继续运行。
为弥补这一调度上的不足,Kubernetes v1.37 引入了用于在节点上直接调整 Pod 大小的调度预占功能(目前处于 Alpha 测试阶段)。该功能需通过 InPlacePodVerticalScalingSchedulerPreemption 功能开关才能启用。借助这一功能,Kubernetes 调度器可以主动抢占那些优先级较低的作业所占用的资源,从而释放出已满节点上的可用容量。这样一来,那些需要调整大小的、优先级较高的应用程序就能顺利执行其调整操作了。
通过调度器对 Pod 的就地调整大小操作进行优先级管理,您可以放心地将集群中未使用的空间分配给那些优先级较低的工作负载。这样一来,就不必担心这些工作负载会影响到优先级较高的 Pod 的正常运行或阻碍其扩展请求。如果某个高优先级的工作负载需要进行的调整超出了节点的可用容量,调度器会自动抢占那些优先级较低的 Pod,从而为高优先级工作负载腾出空间。这样一来,既能提高集群的利用率和成本效益,又能确保关键服务的正常运行和可靠性。
利用 Bind Mount 选项和 EmptyDir 权限来增强容器存储的安全性
Kubernetes v1.37: Hardening Container Storage with Bind Mount Options and EmptyDir Permissions
Kubernetes v1.37 带来了重要的存储安全功能: emptyDir 权限模式和绑定挂载选项。这些功能有助于应用程序开发人员和安全专家实施严格的安全策略。例如,可以禁止在各个容器之间删除文件,或禁止从可写卷中直接执行任意二进制文件,而无需进行复杂的操作。
这些功能的主要目的是通过允许在卷挂载时使用与安全相关的选项,从而提升 Kubernetes 工作负载的安全性。默认情况下,卷是由容器运行时和 kubelet 进行挂载的,此时不会使用 noexec 、 nosuid 或 nodev 等标志。这种默认设置可能会削弱安全性。例如,如果缺少 noexec 标志,那么被攻破的进程就可以利用任何可写卷(如 emptyDir 、PersistentVolume 等)来下载、 chmod +x 和执行任意二进制文件,即便该容器的根文件系统被设置为只读模式( readOnlyRootFilesystem: true )。通过支持 noexec 、 nodev 和 nosuid 标志,用户可以以一种标准化的方式来增强卷挂载的安全性,从而符合各种安全标准和政策要求。
2. GPU 买了却看不见:多租户 Kubernetes 如何安全开放自助指标
GPU 买了却看不见:多租户 Kubernetes 如何安全开放自助指标
背景
在多租户 Kubernetes 集群中,GPU 利用率数据可能早已被 Prometheus 完整采集,真正困难的是:如何让租户团队安全查看只属于自己的指标,同时避免跨租户数据泄露,也不让共享存储被临时查询拖垮。
本文介绍 Adobe 团队基于 Prometheus、kube-rbac-proxy、prom-label-proxy 和 MetricAccess CRD 构建的多租户代理方案。
为什么“直接共享 Prometheus”行不通
最显而易见的方案,是给所有人中央 Prometheus 的只读访问权限。但它会立即遇到两个问题:安全和规模。在一个拥有数千个命名空间的环境中,“所有人都能读取所有内容”并不是一种站得住脚的安全模型。中央 Prometheus 存储着整个资源池的数据。如果数百名工程师同时对它执行临时查询,系统很快就会不堪重负。只需一个代价高昂的长时间范围查询,就可能让所有人都遭遇延迟飙升。
核心思路:在前面放一个代理,用 YAML 定义契约
方案是在中央 Prometheus 前增加一层轻量、具备租户感知能力的代理。这一层完成三件事:
- 识别(Identify):对调用者进行身份验证,并确认其所属租户。
- 隔离(Isolate):在查询语言之下,把每一次查询都限制在该租户的命名空间内。
- 交付(Deliver):可选择把经过筛选的指标切片复制到租户自己的小型 Prometheus 中,让仪表盘和告警都基于租户自有的存储运行。
租户通过一个 Kubernetes 自定义资源 MetricAccess 声明自己需要哪些指标。平台团队负责提供机制,租户团队负责定义策略。这是一份自助式契约,而且整个方案都建立在 CNCF 原生开源组件之上。
各个组件如何协同工作
基础设施 Prometheus 继续完成原有工作:采集整个集群的指标。所有面向租户的访问都必须经过代理。基础设施 Prometheus 位于最上游;多租户代理部署在 monitoring 命名空间,由 Nginx、kube-rbac-proxy 和代理服务组成;下游的各租户通过查询或远程写入接收经过隔离的指标。
读取路径如下:
- Nginx 在多个代理副本之间进行负载均衡。
- kube-rbac-proxy 负责身份认证和授权。
- 代理通过 Kubernetes API 发现后端 Prometheus 实例。
- 代理把查询分发到健康的后端。
- 返回结果会按照该租户允许访问的范围进行过滤,然后再聚合。
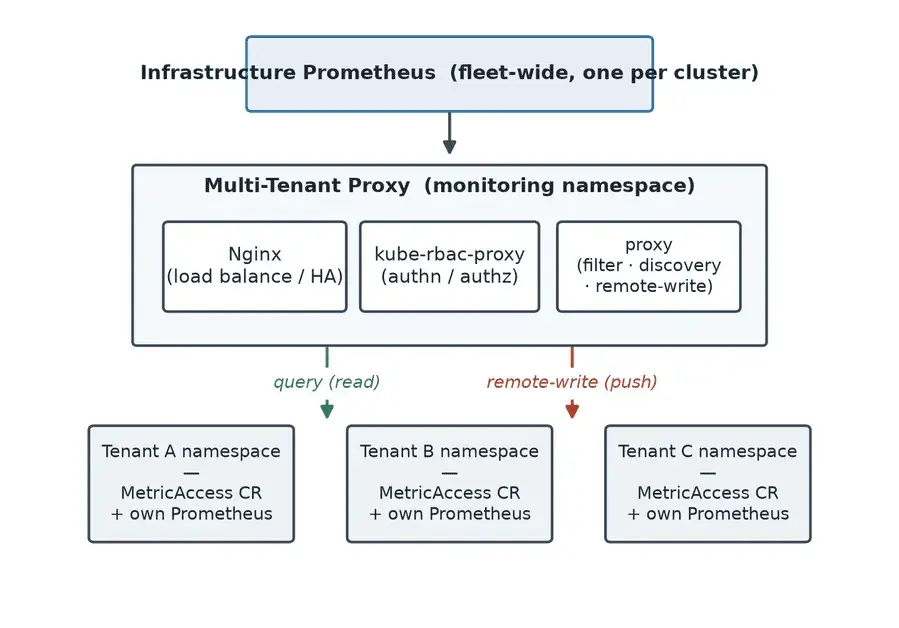
只有在隔离不可绕过时,这套系统才是安全的。
kube-rbac-proxy 使用 Kubernetes 身份与 RBAC 完成身份认证和授权,并确认调用者声明的命名空间。
3. RKE2 与 K3s 集群证书续期与轮换实战指南
背景
在 RKE2 和 K3s 集群中,证书是 Kubernetes 控制平面与节点之间建立信任关系的基础。证书一旦过期,节点之间的身份认证就会失效,进而导致 kubelet、Kubernetes API Server、控制平面组件之间的通信异常,最终表现为集群不稳定甚至服务中断。因此,证书的监控、续期与轮换是 Kubernetes 集群日常运维工作中不可忽视的一部分。
机制
根据 RKE2 与 K3s 官方文档说明,客户端与服务端证书的有效期通常为 365 天。只要证书没有过期,并且距离过期时间还剩 120 天以内,RKE2 或 K3s 在启动时就会自动尝试续期。这类续期会复用现有的私钥(key),只是延长证书的有效期,而不会重新生成新的证书和密钥。若你需要生成新的证书和密钥,而不是仅仅延长旧证书有效期,就需要执行证书轮换(rotation)。
默认情况下,RKE2 和 K3s 在首个 server 节点启动时会自动生成自签名 CA 证书。这样的 CA 证书默认有效期为 10 年,并不会自动续期。
证书续期流程
如果某个证书已经过期,或者距离过期时间不足 120 天,那么只要复用现有的 key,就可以通过重启 RKE2 或 K3s 的 supervisor 进程来完成证书续期。
如果你希望重新生成新的证书和私钥,而不是像续期那样只延长现有证书的有效期,那么需要进行证书轮换。RKE2 和 K3s 的证书轮换适用于两种场景:
- 独立集群
- Rancher 管理下的下游集群
4. 分布式 AI 训练的瓶颈与平台实践
背景
分布式 AI 训练的效率,不只取决于 GPU 数量。当训练任务跨越多个节点,节点间通信、共享存储、硬件拓扑、调度和验证都会影响最终表现。一旦训练跨越多个节点,瓶颈就会出现在应用平台通常很少作为核心问题对待的地方:节点间通信、共享存储、工作负载放置、拓扑和验证。
随着工作负载不断增长,一些训练任务超出了单机在实际使用中的承载极限。模型参数规模进入数百亿级,单个节点无法再同时容纳模型、优化器状态,以及足以支持训练的批次大小。因此,Atlassian 需要一个能够让分布式训练可靠运行、可重复执行的平台,同时让机器学习团队无需面对底层基础设施的复杂性。
问题与解决技术
增加 GPU 是相对容易的部分。平台真正需要让以下三件事变得可预期:
- 通信性能。
- 共享数据访问。
- 运行的可预期性。
两项技术分别解决了前两个问题:
- RDMA(Remote Direct Memory Access,远程直接内存访问):支持 GPU 节点之间以更低开销进行高吞吐量通信。
- Lustre:一种并行分布式文件系统,面向训练数据和检查点的高吞吐量共享访问而设计。
在引入 RDMA 和 Lustre 之前,分布式任务可以运行,但运行得有多快,谁也说不准。通信和存储延迟表现为 GPU 利用率低、训练步骤耗时不均,以及任务运行时间远超预期。
性能退化故障带来了三条具有普遍意义的经验:
- 没有使用者的能力,即使购买成本再高,也可能始终不被看见。 我们没有针对“这个 DaemonSet 从未就绪”设置告警,而这种缺失才是真正的问题。
- 节点自动扩缩容时,Pod 的存续时间和重启次数可能产生误导。 每个新节点都会出现一个新的崩溃循环,看起来像是刚刚发生的故障,但底层问题实际上已经持续了数月。
- 一个正常环境与一个故障环境并存,可能成为陷阱。 预发布环境验证通过,并不能说明生产环境正常,因为前者已经悄悄采用了不同的修复方案。
新的网络与存储设计
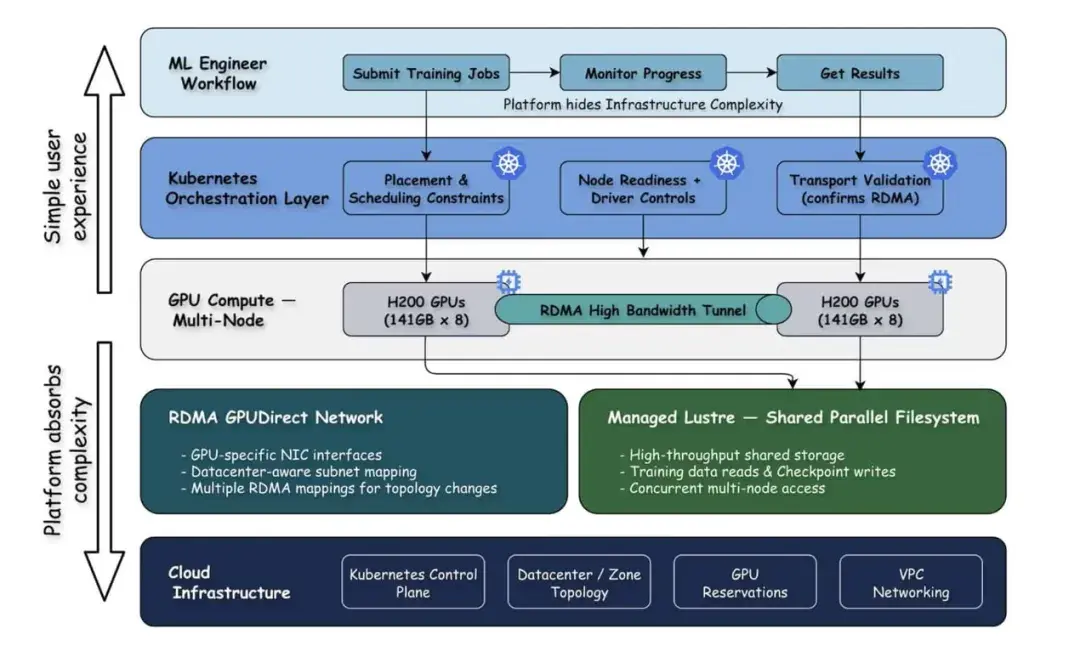
需要在各个层面进行调整:
- 支持 RDMA 的集群和节点池配置。 创建集群时,启用高性能网络所需的多网络支持;配置 GPU 节点池时,绑定具体的预留容量和位置,而不是使用一个通用资源池。
- GPU 专用网络接口和网络映射。 每个 GPU 节点除了普通网络接口,还配有专用 RDMA 接口。每个节点池都映射到与硬件实际物理位置相匹配的 RDMA 网络和子网。
- 节点级依赖、驱动和就绪控制。 在节点镜像中安装 RDMA 用户态库、集合通信运行时和网络插件。未通过就绪检查的节点不会进入可调度状态,从而防止任务落到配置不完整的节点上。
- 通过 Lustre 集成共享存储。 文件系统通过 CSI 驱动,以普通的 ReadWriteMany 类型 PersistentVolumeClaim 暴露出来,并在每个工作 Pod 中挂载到相同路径。通过按命名空间和任务划分的子目录实现隔离。
- 确保硬件和拓扑正确的放置与调度约束。 将任务固定到具备正确硬件、驱动和网络连接的节点池。成组调度(gang scheduling)确保分布式任务要么获得全部工作进程所需的资源,要么继续等待,避免只启动一部分、占着 GPU 却无法推进。
- 工作负载级配置与验证。 在准入阶段,将网络和存储相关配置注入 Pod 规约,机器学习团队无需手工编写这些内容。同时,在认定任务健康之前,先确认其实际使用的传输方式。
平台承担网络、存储和拓扑的复杂性,让提交分布式训练任务仍然是一项普通操作。
一个关键经验是:RDMA 依赖物理拓扑,而不只是 Kubernetes 或工作负载配置。预留的 GPU 容量可能在同一可用区内的不同数据中心之间移动,RDMA 子网映射必须始终与硬件的实际位置保持一致。这意味着,方案需要支持多套 RDMA 网络映射,以及安全的节点池切换,而不能假定某份静态配置永远适用。
平台需要承担多少这类工作,取决于所使用的运行环境。在我们使用的两家云中,其中一家的托管网络会自行处理预留容量和可用区的变化,平台团队完全无需接触这些细节。
我们还必须把预留容量变化当作一次平台切换来处理:先引入新节点池,再安全迁移工作负载,最后停用旧路径。实践证明,这比试图把整个问题当成一次性配置任务处理更加可靠。
5. 在 Amazon EKS 上使用 ECR 仓库策略实现按 Pod 级别的镜像拉取权限
Implement per-pod image pull permissions with ECR repository policies on Amazon EKS
背景
如果您所在的组织运营着一个支持多租户的 Amazon Elastic Kubernetes Service(Amazon EKS)集群,那么您可能需要根据各个团队的需求来限制对 Amazon Elastic Container Registry(Amazon ECR)容器镜像仓库的访问权限。每个团队只需要访问属于自己的镜像仓库,而不得访问其他团队的镜像。
默认情况下,Amazon EKS 会在节点级别配置对 Amazon ECR 的镜像拉取权限。运行在同一个节点上的 Pod 共享相同的节点凭据以及对 ECR 仓库的访问权限,而不受所属团队的影响。虽然每个团队可能拥有自己的 ECR 仓库,但共享的节点角色使得集群中的 Pod 能够平等访问 Amazon ECR。
AWS 在 Amazon EKS v1.35 及更高版本中已完全支持这一功能。
方案概述
在 Amazon EKS 集群中,每个节点都会被分配一个与节点相关的 AWS 身份与访问管理(IAM)角色。每个节点上的 kubelet 进程会使用这个角色来执行配置容器所需的操作,例如从 Amazon ECR 下载容器镜像。而镜像下载的认证功能则由特定于提供商的二进制文件来处理,这些二进制文件被称为凭证提供者。当配置一个 Pod 时,kubelet 会将镜像 URI 与相应的凭证提供者二进制文件进行匹配,然后调用该二进制文件来执行认证和下载容器镜像的操作。EKS 节点默认预装了 ecr-credential-provider 组件,这使得 kubelet 能够利用节点的 IAM 角色进行 ECR 的认证,并下载容器镜像。
当在 CredentialProviderConfig 字段中配置了 tokenAttributes 参数时,kubelet 会将绑定在 Pod 上的服务账户令牌传递给凭证提供者。然后,ECR 凭证提供者可以使用在 Pod 服务账户注释中定义的 IAM 角色来进行身份验证,而不是使用节点的 IAM 角色。这一过程是通过调用 AWS 安全令牌服务 AssumeRoleWithWebIdentity API 来实现的。这样,每个团队都可以使用自己的 IAM 角色来进行 ECR 访问,而平台团队则可以通过 ECR 仓库策略来限制或允许对私有仓库的访问。
两层执行机制协同工作:IAM 角色范围决定了 Pod 被认证为谁,而 ECR 仓库的策略则规定了该身份可以访问哪些资源。
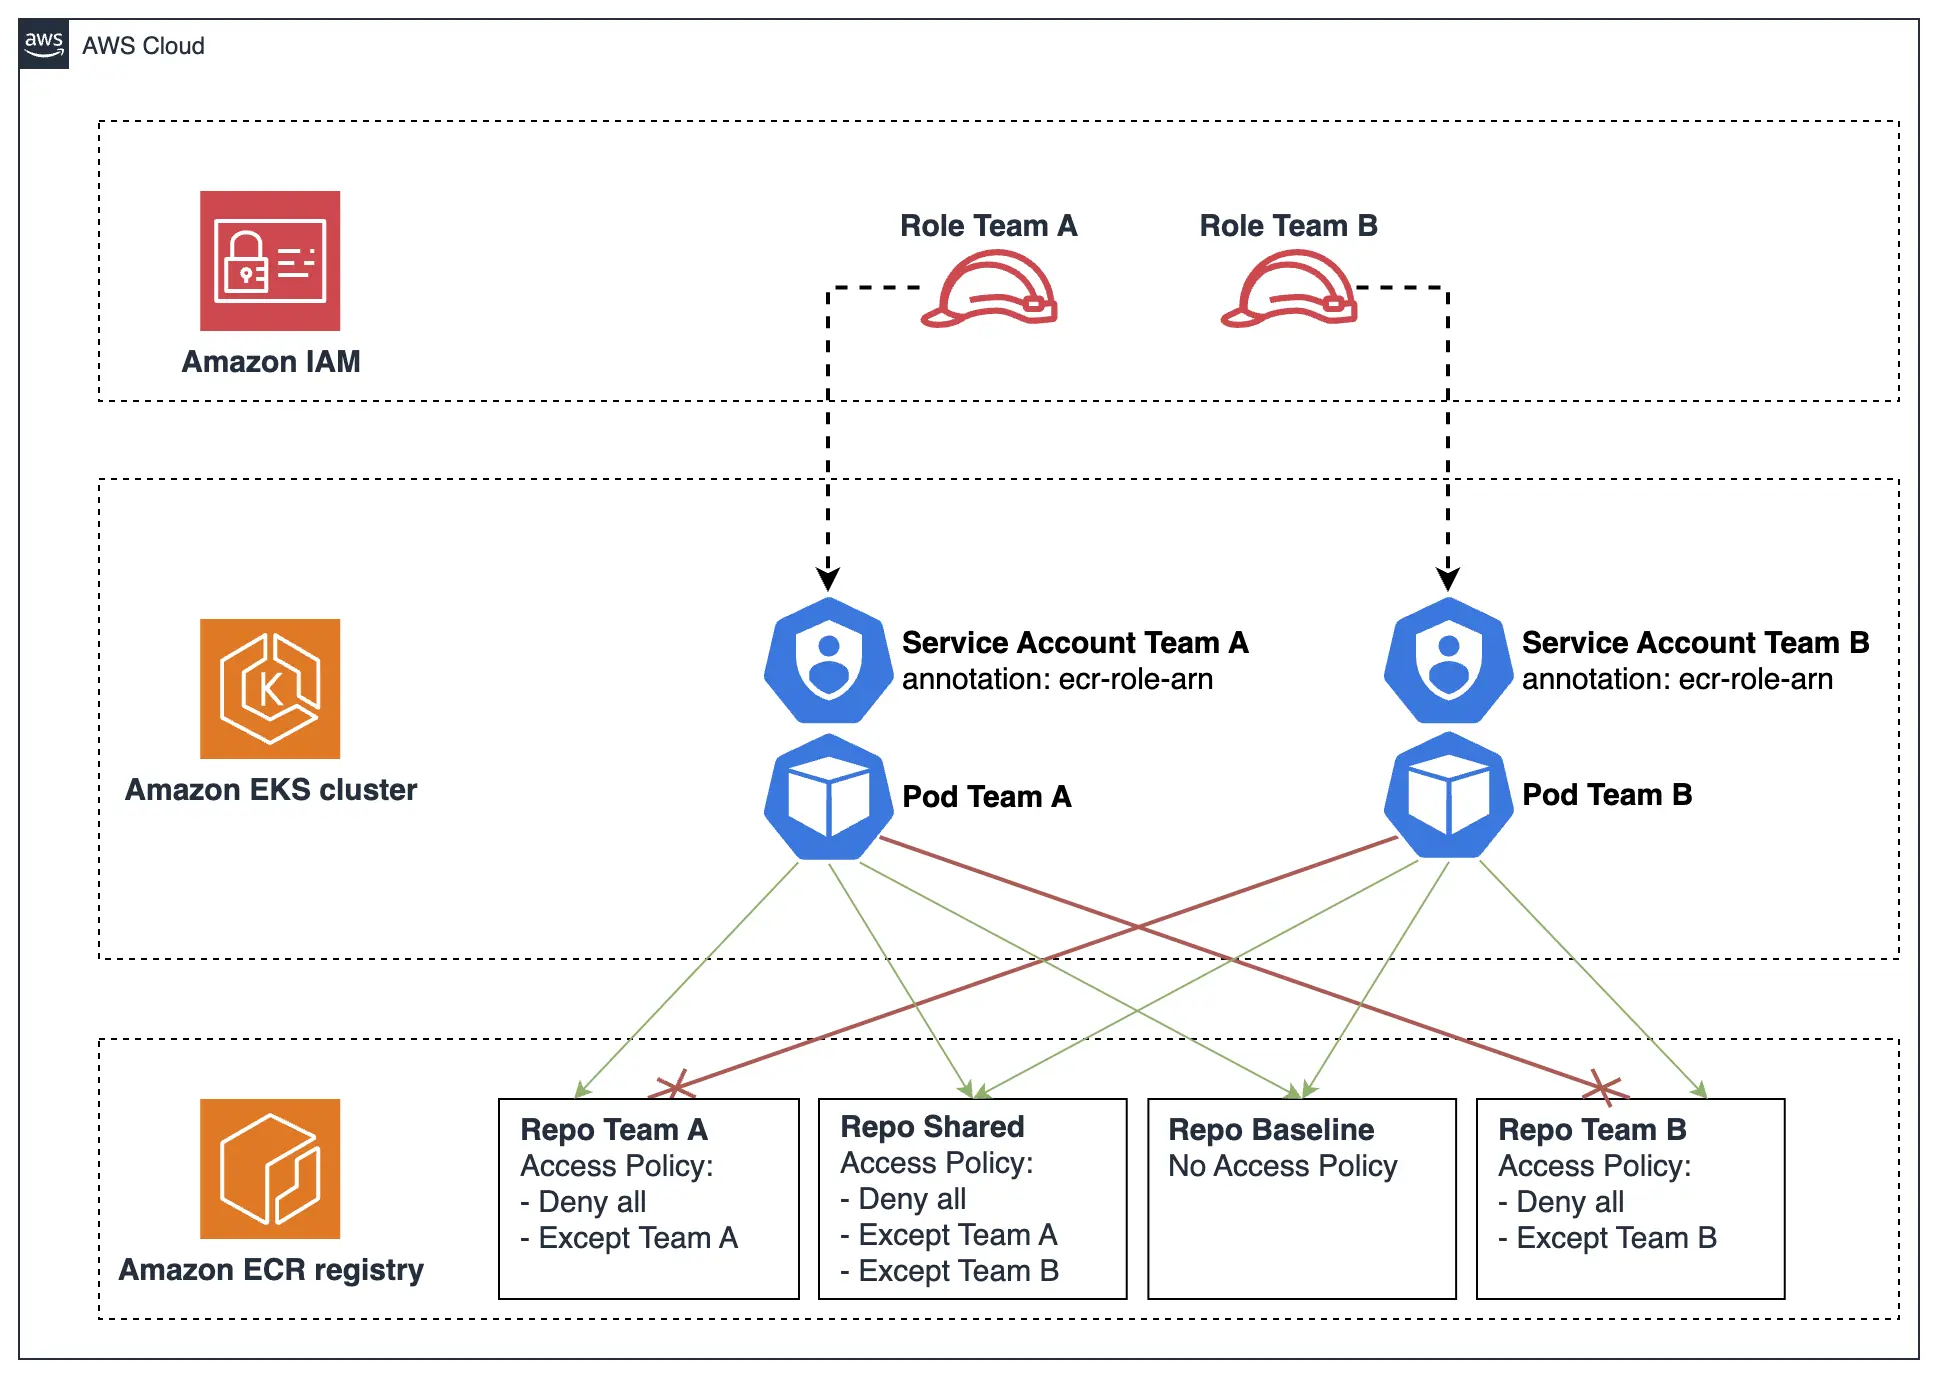
流程简介
- 每个团队都会创建一个用于拉取 IAM 角色的接口,该角色的 OpenID Connect(OIDC)信任策略与团队的服务账户相关联。
- 团队应用程序会使用带有 eks.amazonaws.com/ecr-role-arn 服务账户注释的 Pod 来创建容器,该注释指向了团队拥有的拉取 IAM 角色。
- Kubelet 会展示与 Pod 绑定的服务账户令牌,并将其传递给 ecr-credential-provider。
- provider 读取 ecr-role-arn 注释,并使用 OIDC 令牌和角色 ARN 调用 STS 的 AssumeRoleWithWebIdentity 接口。
- STS 会验证 OpenID Connect(OIDC)令牌是否与集群中的 OIDC 提供者匹配,然后返回适用于团队 IAM 角色的临时凭证。
- provider 使用团队 IAM 角色的凭据调用 ECR 的 GetAuthorizationToken。
- ECR 返回一个授权令牌。提供者会将该令牌返回给 kubelet。
- Kubelet 通过容器运行时机制,使用 ECR 令牌来下载 ECR 上的镜像。
- ECR 目前正在评估存储库的资源策略。如果策略允许该团队拥有 IAM 角色,那么拉取操作就会成功。如果策略拒绝该主体(例如,其他团队的角色或节点角色),那么拉取操作将会失败,并会返回 403 Forbidden 作为错误信息。
6. Amazon EKS 通过 Kubernetes 任务调度器解决容器分发策略的偏差问题
Fix pod distribution drift in Amazon EKS with the Kubernetes descheduler
背景
如果工作负载分布在三个区域中,那并不意味着这些工作负载会保持均匀分布。在对亚马逊弹性 Kubernetes 服务集群进行测试时,我们发现,在短暂的节点不可用期间,大约 1,000 个容器组成的集群仅分布在两个区域中;而第三个区域中的容器数量则降为零。当容量恢复后,这种不平衡状态持续了超过 16 小时,期间每个节点都保持正常运行且可调度。
Kubernetes 使用默认的 kube-scheduler 组件来分配 Pod。当你提供工作负载的拓扑结构时,调度器会在资源分配时(即 Pod 首次被分配时)根据这些拓扑结构进行评估,其评分算法会根据节点的适用性对候选节点进行排名。
在拓扑结构中,有三个因素决定了扩展约束的运作方式:
- 拓扑键:用于标识某个域的节点标签。在区域扩展中,这个标签就是 topology.kubernetes.io/zone。
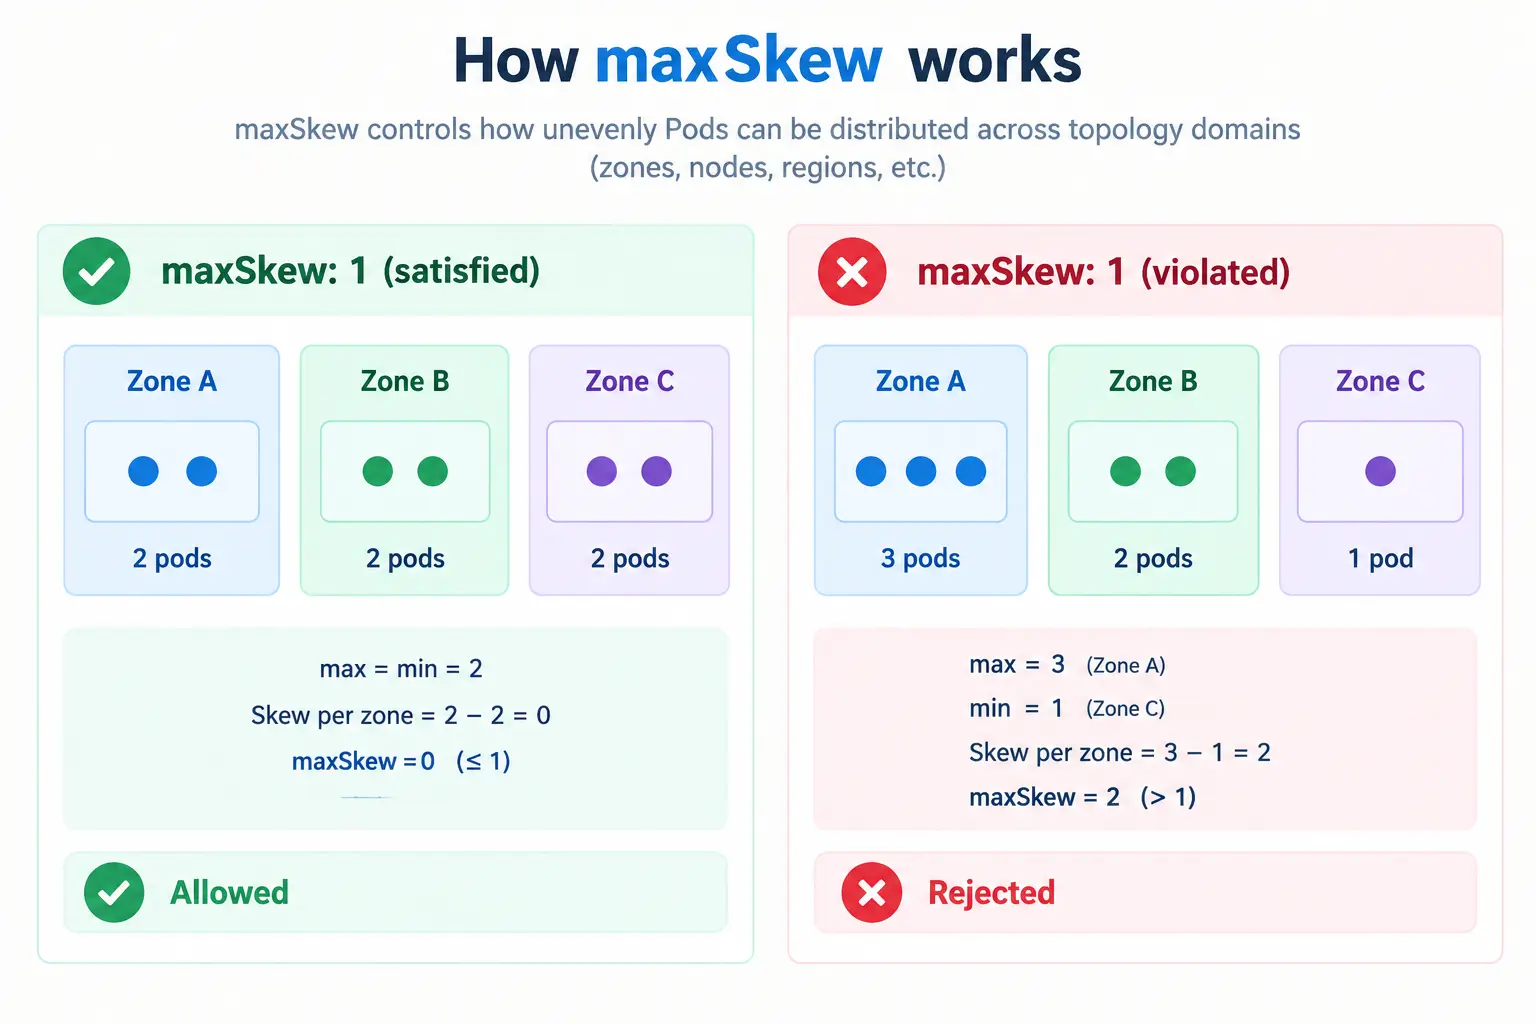
- maxSkew:最繁忙的域与最不繁忙的域在匹配节点数量上允许的最大差异。
- 当无法满足要求时:当调度器的调度结果超出最大倾斜范围时,系统会执行何种操作。这就是软调度和硬调度之间的区别所在。
解决方案
Kubernetes 调度器基于周期性循环运行。它不属于准入控制器,也不负责调度 Pod 的分配。该调度器会根据预设的策略来评估集群中的运行状态,将违反该策略的 Pod 移除(移除操作是一种受控的 Pod 终止过程,之后会重新安排其他 Pod 的调度)。至于新 Pod 的分配,则由 kube-scheduler 负责处理。由于 Kubernetes 调度器使用了“Eviction API”,因此可以通过设置“PodDisruptionBudgets”规则来控制同时不可用 Pod 的数量。
对于漂移问题,相关的插件是 RemovePodsViolatingTopologySpreadConstraint。默认情况下,该插件仅对硬性约束起作用。在约束条件中设置 ScheduleAnyway 参数,使其能够对软性约束生效,而这正是大多数工作负载实际使用的配置方式。
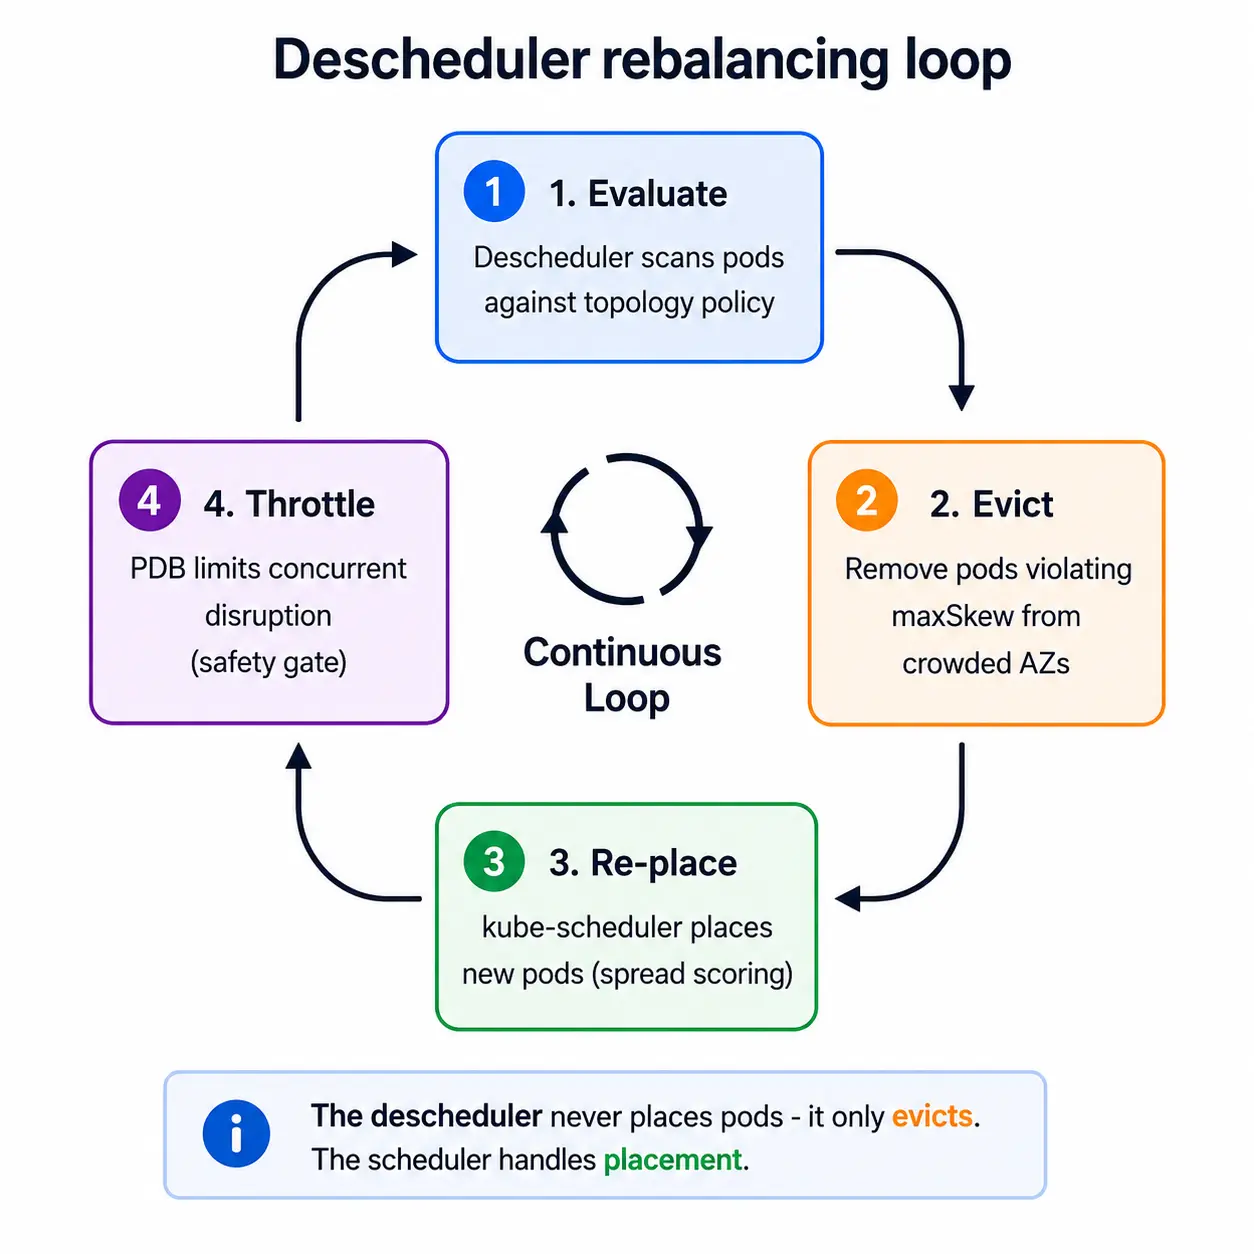
用软拓扑分布约束保证可用性,再用 Kubernetes descheduler 周期性把跑偏的分布拉回声明状态。
📄 专题五 报告查看与分析
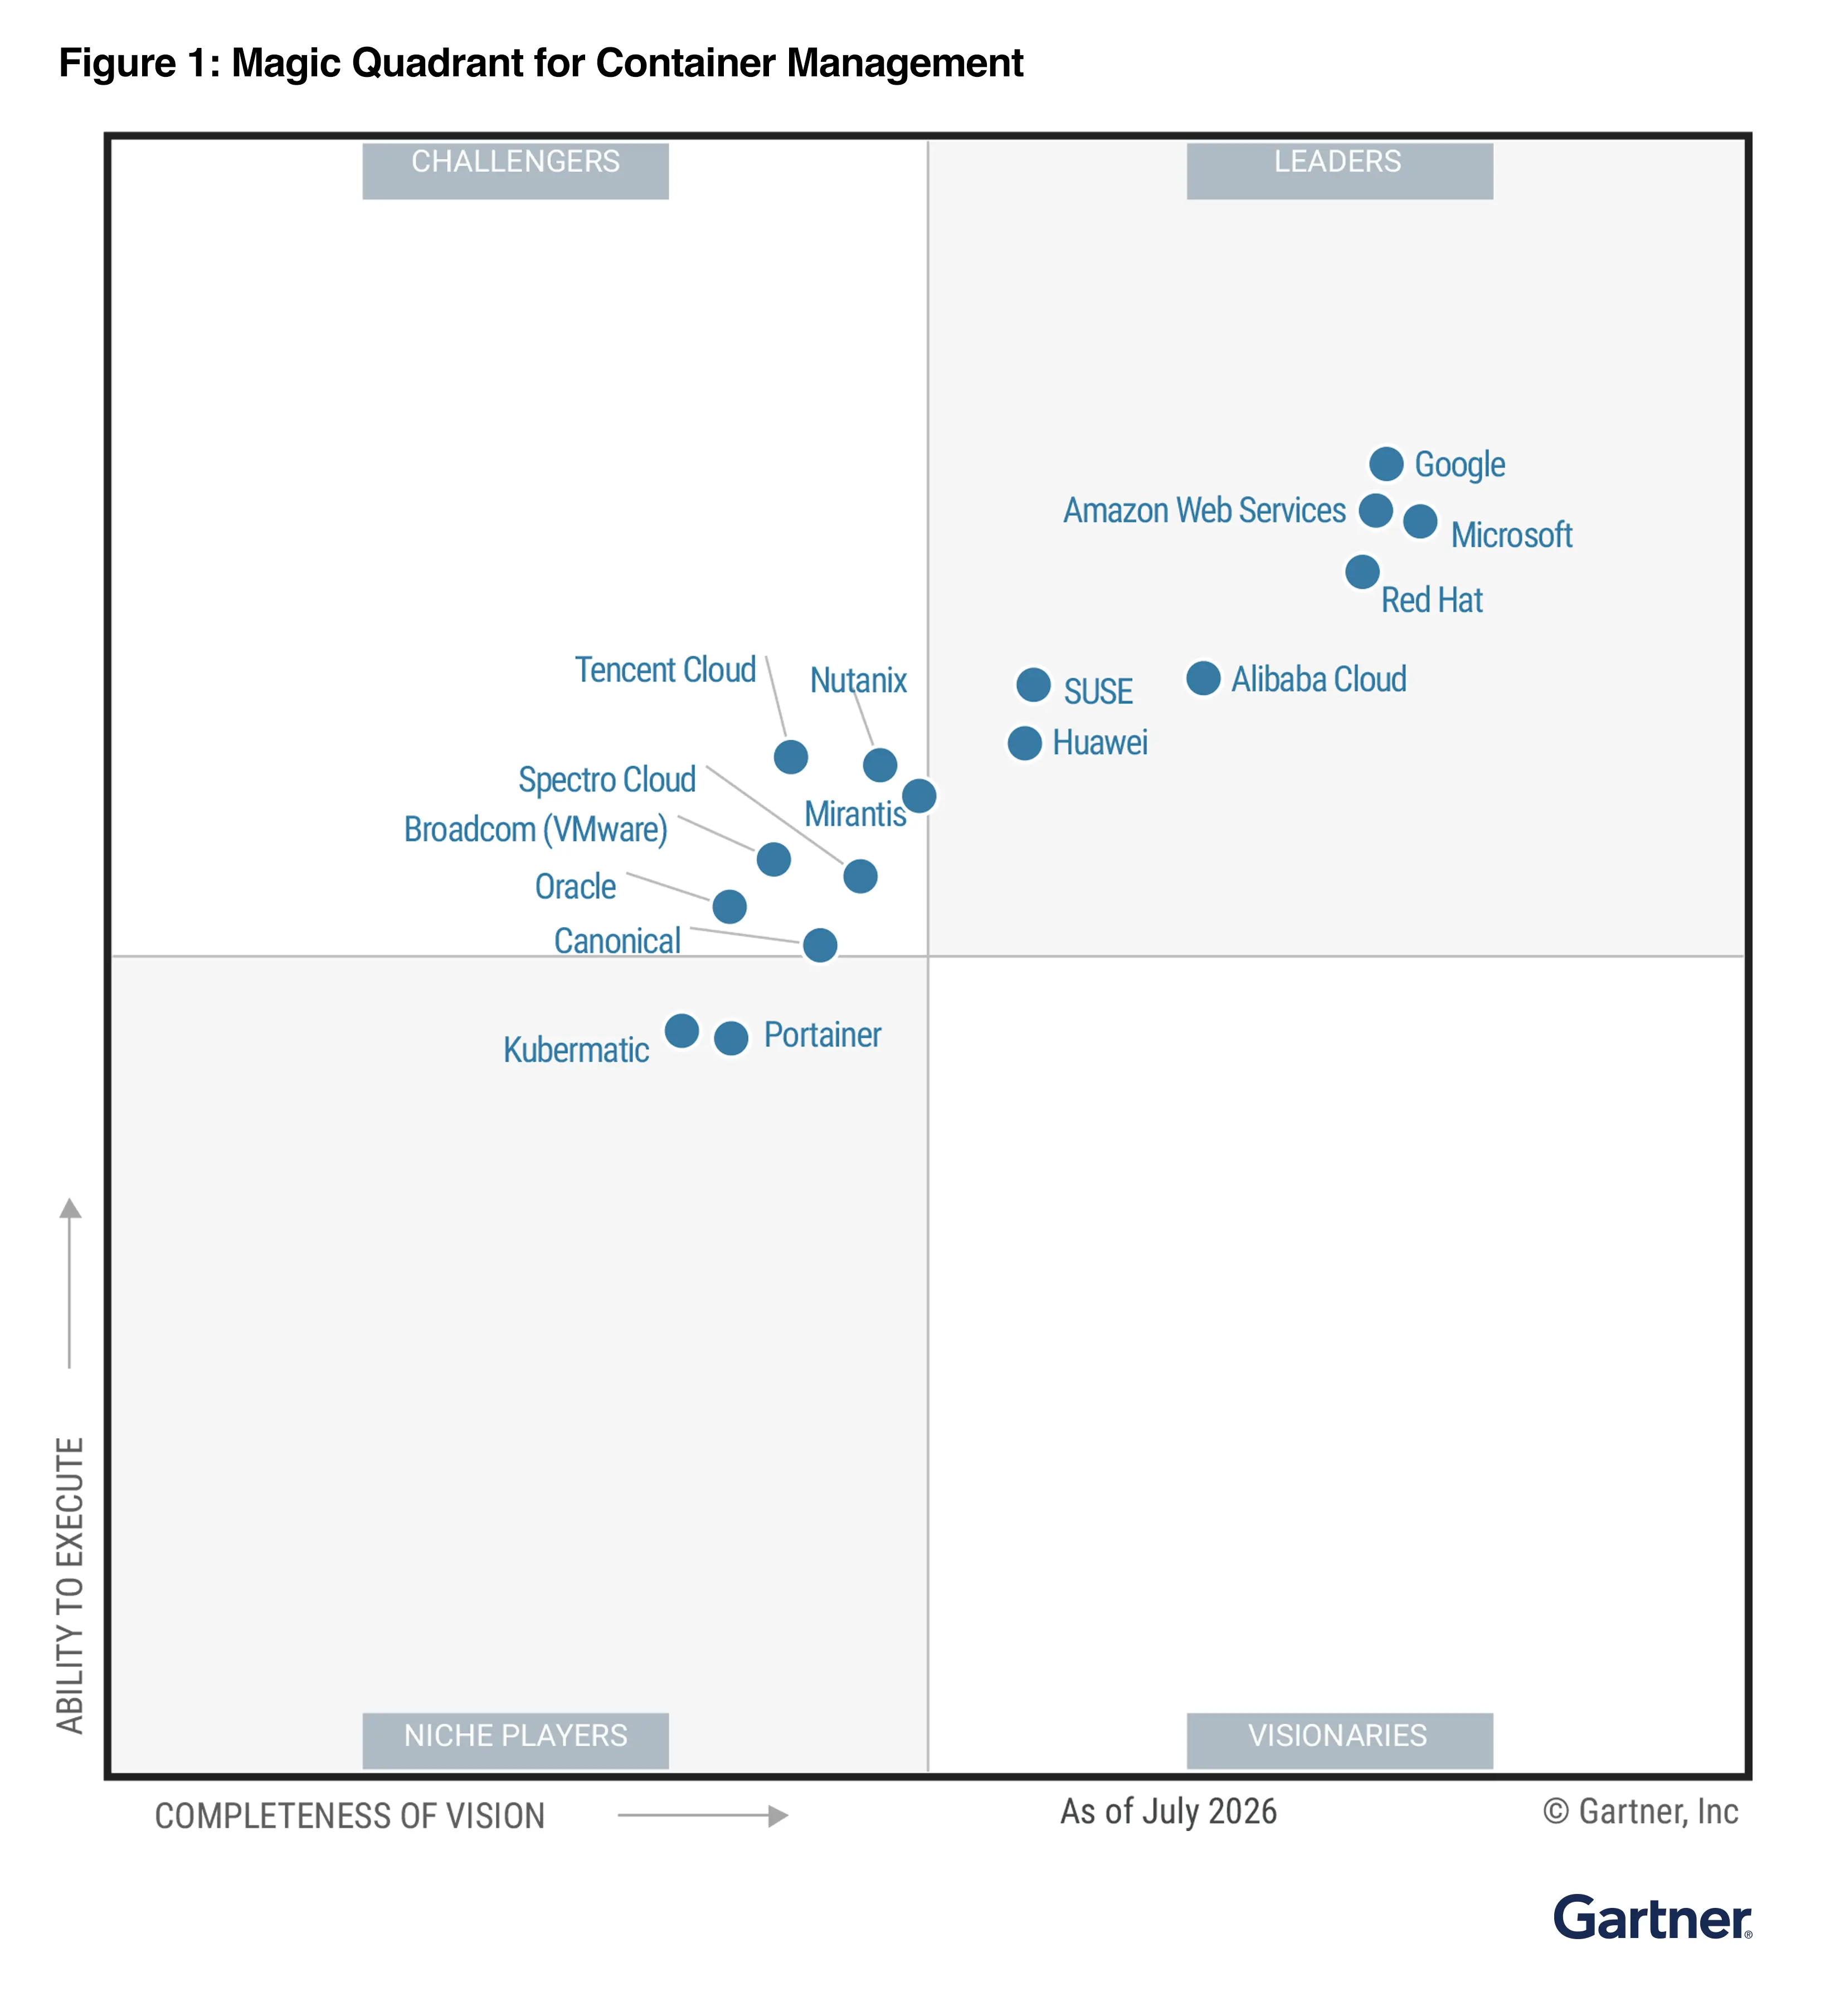
1. 2026 Gartner Magic Quadrant for Container Management
Magic Quadrant for Container Management
Gartner 将容器管理定义为一种能够支持容器工作负载及相关资源部署与运行的解决方案。这类解决方案采用多种开源技术相结合,以实现应用程序的敏捷部署与基础设施的现代化改造。其交付方式可以是独立软件的形式,也可以以服务的形式提供。
容器管理能够自动化地大规模配置、操作及管理容器化工作负载。通过集中化的治理和安全策略,可以管理容器工作负载及相关资源。容器管理符合现代应用程序的需求(同时还能对传统应用程序进行重构),包括平台架构设计、云管理以及持续集成/持续交付流程等。其优势包括提升的灵活性、弹性性,以及获取更多创新机会的能力。
强制功能:
- 编排与调度
- 容器运行时环境
- 服务发现与注册
- 制品仓库
- 路由与网络
- 服务目录包含并展示了各种应用程序与基础设施相关的组件
- 管理界面
- 可通过 API 访问相关资源
💁♀️ 专题六 产品/方案介绍
1. HKS:HPE 推出的 CNCF 认证 Kubernetes 发行版
Developers and platform teams both want Kubernetes self-service. They disagree on who owns it.
简介
HKS 全称为 HPE Kubernetes Service,是惠普企业(HPE)推出的内置企业级 Kubernetes 服务。它作为 HPE Morpheus Software(多云与混合云管理平台)的核心组件,为企业提供了一个跨私有云、公有云及多云环境的统一控制平面,用于一键式部署、扩展和管理 Kubernetes 集群。该发行版有助于平台团队构建和管理 Kubernetes 环境,从而将 Kubernetes、虚拟机器、基础设施以及公有云整合到统一的运营模式中。
聚焦的问题
如何划定 Kubernetes 自服务模式的界限:哪些任务可以安全地交给开发者处理,而哪些任务则仍然需要由平台团队来负责呢?
自行构建自助服务层的团队通常会遇到两个常见问题:
- 工具和组件的分散分布:为了使上游的 Kubernetes 能够投入生产使用,平台团队必须精心维护一个不断发展的第三方 CNCF 工具生态系统,这些工具包括网络管理、存储管理、入口管理、身份管理以及策略执行等功能。要管理和支持这一分散的生态系统,需要大量的维护工作,这对内部平台团队来说是一个巨大的负担。
- 在 Day 2 的工作中,生命周期管理和混合环境的复杂性是一个重要的挑战:虽然启动一个 Kubernetes 集群相对简单,但保持集群的更新状态——在开发、测试、预发布和生产环境之间——却需要大量的工作。这就是为什么 HPE 认为每次升级 Kubernetes 集群时,都必须检查与其相关的网络、存储、身份识别以及策略组件是否处于最新状态。当集群分布在裸机环境、私有云、边缘站点或公共云中时,问题变得更加复杂,因为一次性脚本和特定于环境的配置很容易导致不一致性问题。这种维护负担应该由平台团队来承担,而不是由那些试图交付应用程序的开发者来承担。
解决方案
解决方案并非是无限制的访问权限。而是有一条明确的路径:开发者可以自行申请到经过批准的 Kubernetes 服务,而这些服务的访问、配置、部署方式以及审批流程等细节,都由平台团队来负责制定。最适合实现自助服务的请求是那些可以重复执行、风险较低且易于理解的请求。
HPE Morpheus 通过服务目录、可复用的布局与蓝图、工作流程、基于角色的访问控制、审批机制、API 功能以及自动化工具来提供这些选项。开发人员无需失去对 Kubernetes 的直接控制能力,因为他们仍然可以通过标准的 Kubernetes 接口和工具进行访问。同时,平台团队对相关的请求处理、管理流程以及生命周期管理进行了标准化处理。这些目录项不仅可以包含基础设施相关的设置,还可以集成那些被认可的服务和应用组件,这些组件有助于支持开发流程——包括持续集成/持续部署工具、源代码和工件仓库、容器注册表以及运行时依赖项等。而这些组件的配置和管理则由平台团队负责。
开发者们可以选择那些对应用程序至关重要的参数:
- 已批准的 Kubernetes 版本和集群规模:可以选择经过测试合格的 Kubernetes 运行时版本以及节点数量模板。
- 资源配额:可以根据工作负载的需求,指定所需的 CPU 资源、内存以及持久存储容量。
- 集成化的工具集和集成开发环境:可以选择所需的开发者工具链、容器镜像仓库以及运行时依赖项。
- 租赁期限和持续时间限制:为临时开发或沙盒集群定义明确的运行生命周期,以避免造成不必要的基础设施浪费。
网络隔离、身份提供者集成、安全政策以及成本分配这些功能由平台团队负责处理,它们会通过已批准的服务配置自动生效。
产品价值
通过将基础设施编排、基于角色的访问控制以及多租户功能整合到一个统一的运营体验中,HPE Morpheus 软件能够将这些配置流程的耗时缩短到几分钟或几小时。这样的结果不仅意味着集群的部署速度更快。HPE Morpheus 软件还能通过自动化方式将资源接入开发者的现有交付流程中,使得经过批准的 CI/CD 流程以及应用程序服务能够随环境一起被使用。
更快的资源配置过程也会带来另一个问题:速度过快会导致团队难以追踪究竟分配了什么以及为什么要分配这些资源。HPE Morpheus 软件能够让管理员随时了解资源的使用情况及成本状况,而租赁控制功能则可以在临时开发集群的租赁期限到期后自动将其关闭。
2. Kamaji:基于“托管控制平面”概念设计的 Kubernetes 控制平面管理工具
简介
Kamaji 的方法是基于在 Pod 中运行 Kubernetes 控制面组件,而不是使用专门的机器来运行这些组件。这样能够大规模地管理 Kubernetes 集群,同时大大降低了操作成本。通过这种方式,部署和运营多个控制面变得更加经济且容易。
主要特点
- 快速的资源部署时间:根据基础设施的情况,Tenant Control Plan 可以在 16 秒内上线并开始处理流量。
- 简化的更新说明:对于某个特定租户的控制平面,升级到新版本的 Kubernetes 只需 10 秒钟即可完成。同时,我们会采用蓝绿部署方式,以避免同时提供不同版本的 Kubernetes,从而确保系统的稳定性。
- 资源优化:由于采用了数据存储的分离机制,因此无需使用奇数实例(例如:RAFT 共识机制),从而可以节省高达 60% 的硬件资源。
- 从零开始逐步扩展:当资源不再被使用时,可以缩小实例的规模;或者利用 Kubernetes 的自动化机制,在流量高峰时自动扩展实例以支持更高的负载。
- 声明式方法、持续协调:得益于操作符模式的应用,状态检测能够实时进行,从而保持期望的状态。
- 自动化证书管理:Kamaji 利用 kubeadm 的功能,为您自动创建并轮换证书。
- 管理核心插件:Kamaji 允许自动配置 kube-proxy 、 CoreDNS 和 konnectivity 参数,并且在用户出错时(例如删除 CoreDNS 部署配置时)会自动进行修复。
- 自动修复:管理集群中的 TenantControlPlane 对象由 Kamaji 进行跟踪。如果这些对象被删除,系统会以一种幂等的方式重新创建这些对象。
- 数据存储多租户化:可选地,Kamaji 允许在同一数据存储实例上运行多个控制策略,从而利用各驱动程序的多租户特性,减少操作开销并优化成本。
- 突破 etcd 的限制:可选地,Kamaji 允许使用不同的数据存储方式,通过支持 MySQL、PostgreSQL 或 NATS 作为替代方案来实现。
- 简化混合网络架构:感谢 Konnectivity 的帮助,tenant 控制平面能够连接到位于不同网络中的工作节点。这样就能克服在处理具有不可路由 IP 地址的节点时出现的 NAT 不可用问题(例如:位于不同基础设施中的工作节点)。
🤔 专题七 有意思的事与 Meme
本月无